研究概览
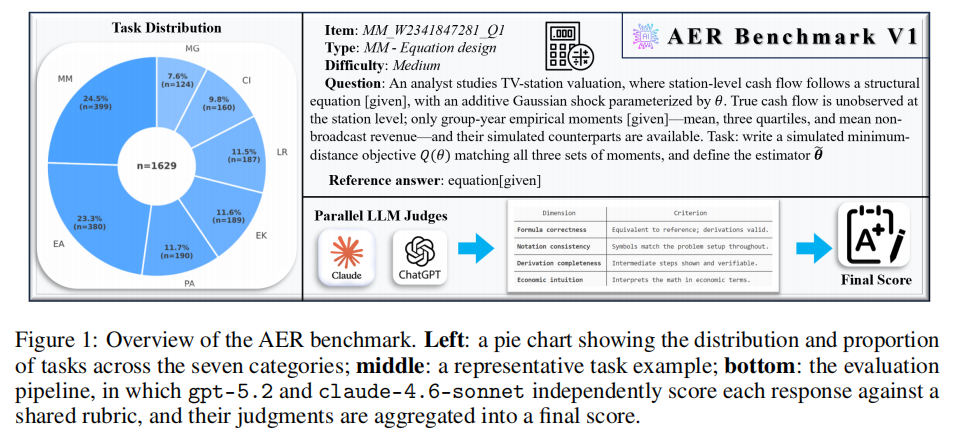
AER-bench 是一个面向自动经济研究全流程的大语言模型评测基准。与只覆盖孤立问答的已有基准不同,它沿研究工作流设置文献综述、经济知识、概念识别、论文摘要、经济分析、数学建模与模型生成七类任务。数据来自 191 篇 2025 年 AER 与 Econometrica 开放获取论文,以及约 900 段 1900–1950 年经济学历史文献,共 1,629 题。经济知识与概念识别由规则评分,其余开放任务由 claude-4.6-sonnet 与 gpt-5.2 两个裁判按共享量表独立打分。对 16 个前沿模型的匿名投稿版评测显示:纯 LLM 在知识密集任务上仍不稳定,同家族模型呈现相似模式,部分模型对早期经济学概念存在明显“现代性偏差”。
这项研究试图解决什么问题?
研究背景
经济研究从文献综述、数据清洗到模型设定、推导、稳健性检查和结果解释,包含大量可被生成式 AI 辅助的重复环节。工具型智能体已经表现出执行工作流的能力,但既有经济学基准多聚焦行为模拟、生产力替代、事件推理或金融分析,通常不直接取材于顶级期刊论文,也难以覆盖领域知识、数学建模和经济分析。因此,自动经济研究需要一套从文献处理延伸到模型生成、能够分任务检验能力的独立标尺。
语言模型在自动经济研究的哪些环节表现较强,哪些环节仍不可靠?如何用可复现任务与混合评分框架衡量这些差异?
具体研究内容
- 按研究工作流定义文献综述、经济知识、概念识别、论文摘要、经济分析、数学建模和模型生成七类任务。
- 以 LLM 多轮抽取和经济学博士生标注构建现代顶刊与历史文献的双数据源。
- 结合规则评分、双裁判多维量表和 bootstrap 显著性检验形成混合评估框架。
- 评测 16 个前沿模型,分析总体排名、逐任务能力、模型家族模式与历史概念的现代性偏差。
研究是怎样完成的?
数据层结合两个互补语料:191 篇 2025 年 AER 与 Econometrica 开放获取论文经 LLM 多轮抽取转化为自足任务;约 900 段 1900–1950 年历史文献由经济学博士生按八个概念维度标注,形成 160 道概念识别题,最终合计 1,629 题。评测层中,经济知识 EK 与概念识别 CI 使用程序化规则评分;文献综述 LR 同时考虑引用召回与写作量表;论文摘要、经济分析、数学建模和模型生成等开放任务由 claude-4.6-sonnet 与 gpt-5.2 两个裁判按维度细则独立打分。七类任务等权汇总,并用逐题 bootstrap 置信区间与配对检验比较模型。
构建双源题库
从现代顶刊论文自动抽取任务,并对历史文献进行专家概念标注。
执行零样本推理
让 16 个模型在统一设定下完成七类经济研究任务。
混合评分
确定性任务采用规则评分,开放生成任务由两个独立裁判按共享量表评分。
聚合与显著性分析
七类任务等权汇总,并以 bootstrap 置信区间和配对检验比较模型。
核心创新
- 以自动经济研究全流程为评测对象,从顶级期刊论文取材并覆盖领域知识、文献处理、经济分析和数学建模,而不是只评估孤立问答。
- 结合 2025 年顶刊前沿材料与 1900–1950 年历史文献,使跨年代的概念理解和“现代性偏差”能够被单独分析。
- 把规则评分、双 LLM 裁判、多维量表与配对 bootstrap 检验组合在一个框架中,以兼顾确定性任务的客观性和开放任务的可评估性。
- 论文抽取与历史材料标注构成可复用的数据生产管道,使基准可以继续扩展到更多年份、期刊和学科。
如何检验,得到了什么结果?
- 任务数据
- 191 篇 AER/Econometrica 2025 开放获取论文,加约 900 段 1900–1950 年历史文献,共 1,629 题。
- 七类任务
- 文献综述 LR、经济知识 EK、概念识别 CI、论文摘要 PA、经济分析 EA、数学建模 MM 与模型生成 MG。
- 受测模型
- 16 个前沿模型:OpenAI 6 款、Anthropic 3 款、Google 3 款,以及 kimi、glm、doubao、qwen 等 4 款开源或区域模型。
- 推理设置
- 所有模型采用统一的零样本推理,不加入检索增强、外部工具或多步智能体流程。
- 评分方法
- EK/CI 采用规则评分;LR 结合引用召回与写作量表;PA/EA/MM/MG 由两个独立裁判按维度权重打分后取平均。
- 统计检验
- 七类任务各占总体分的 1/7;逐题计算 95% bootstrap 置信区间,并执行配对 bootstrap 显著性检验。
验证路径
任务数据
191 篇 AER/Econometrica 2025 开放论文与约 900 段 1900–1950 历史文献,共 1,629 题。
受测模型
匿名投稿版报告评测 16 个闭源与开源前沿语言模型,全部采用零样本推理。
评分框架
经济知识与概念题用规则评分;其余五类任务由两个裁判模型按多维量表评分。
主要结果
- 总体排名:匿名投稿版报告 gpt-5.4 总分 75.0%,其中 MM 为 92.8%、MG 为 85.8%、EA 为 81.6%;但它与 claude-4.6-opus 的 74.0% 在配对 bootstrap 下无显著差异(p=0.092)。
- 家族模式:Claude 三款模型的总分集中在 73.4%–74.0%,CI 达到 72.7%–72.9%,高于 gpt-5.4 的 58.9%;OpenAI 家族版本间波动较大,gpt-4o 总分为 54.0%,EK 为 25.6%。
- 任务专长:gemini-3.1-pro 总分 71.6%,但在 EK(76.3%)与 PA(74.3%)上排名最高;kimi-k2.5 总分 69.1%,显示部分开放模型在该基准上接近闭源模型。
- 任务难度:文献综述中位分最低,约为 40%,且模型分布集中;数学建模中位分接近 90%;经济知识与模型生成的模型间差距最大。
- 现代性偏差:较弱模型在 20 世纪初历史概念题上下降 20 个百分点以上,而部分领先系统在早期与近期概念上的表现接近;差距主要出现在较长的来源段落。
图表与证据
代表图
概览七类工作流任务、代表问题与双裁判评分流程。
AER-bench 评估的是从文献到建模的组合能力,而不只是经济知识问答。Table 3
列出 16 个模型的总体排名、逐任务得分和 95% bootstrap 置信区间。
领先模型总体接近,但各家族和各任务的能力结构明显不同。Figure 3
展示七类任务上模型得分的中位数、均值和范围。
文献综述普遍较弱,数学建模整体较强,知识与模型生成最能拉开差距。这项工作意味着什么?
主要贡献
- 建立包含 1,629 题和七类任务的自动经济研究综合基准,填补直接从顶刊论文构造研究能力评测的空白。
- 形成 LLM 多轮抽取与经济学专家标注的双数据生产管道,支持基准持续扩展与跨学科迁移。
- 设计规则评分、双裁判量表和 bootstrap 显著性检验结合的混合评估框架,以控制开放任务中的主观性与抽样噪声。
- 识别知识密集任务不稳定、模型家族模式和历史概念现代性偏差,为后续检索增强与工具型经济研究智能体提供诊断依据。
总结
AER-bench 以顶刊论文和历史文献构建七类研究工作流任务,并通过规则评分与双裁判混合框架评测 16 个前沿模型。匿名投稿版结果显示,领先模型总体接近,但文献综述、经济知识和历史概念理解仍表现出明显差异。该基准把“自动经济研究”分解为可以逐项比较的能力,为检索增强、工具调用和智能体化研究系统提供试验场;其排名仍依赖当前题库与评分器,需要在数据、代码和结果公开后接受复核。
基准为英语单语,现代论文只覆盖 AER 与 Econometrica 2025 年开放文章;开放任务依赖 LLM-as-judge,并检测到轻微裁判家族偏差;零样本评测尚未覆盖检索增强或工具型智能体。