研究概览
人工智能在提升生产率的同时,正在重塑劳动力市场与收入分配,政府的财政政策应如何回应?该工作构建了一个具有内生技能积累的多智能体强化学习模型:经济位于二维空间网格中,人类依靠个人经验缓慢“干中学”,AI 则以近零边际成本复制全球技能前沿,形成快速知识扩散。在模型中,AI 使总产出提高 33.5%,但替代中等技能人类并使平等指标从 0.72 降至 0.44。论文采用双层循环 MARL,由政府选择状态依赖税率、人类与 AI 智能体内生调整行为;学得税制将平等恢复到 0.95 且维持高产出。进一步比较所有权与共享制度后,公共所有和实时共享组成的“数字公地”在作者设定的福利目标下表现最佳。
这项研究试图解决什么问题?
研究背景
生成式 AI 正逐渐成为通用目的技术,认知自动化可能冲击非程序性任务并造成中等技能群体“空心化”,而最优税收文献对机器人和 AI 应该征正税、零税还是负税仍有分歧。与此同时,闭源与开源模型的争论体现了知识扩散效率与投资维护激励之间的制度权衡。经验证据只能回顾已有冲击,解析模型在纳入空间摩擦、丰富异质性和内生学习后又难以求解,因此需要一个能够生成条件性反事实并允许行为内生响应的计算实验框架。
当 AI 能够低成本复制认知技能并快速传播知识时,税收、转移与知识共享制度如何影响产出、平等和社会福利?
具体研究内容
- 构建空间化 MARL 经济,显式区分人类“干中学”与 AI“集体智能”的技能积累机制。
- 用双层循环强化学习联合求解智能体行为响应与政府状态依赖的税收–转移政策。
- 分析 AI 引入后的技能分化、职业选择、收入分配与 U 形边际税率。
- 比较私有/公共所有与封闭/定期/实时共享,研究数字公地的模型条件福利。
研究是怎样完成的?
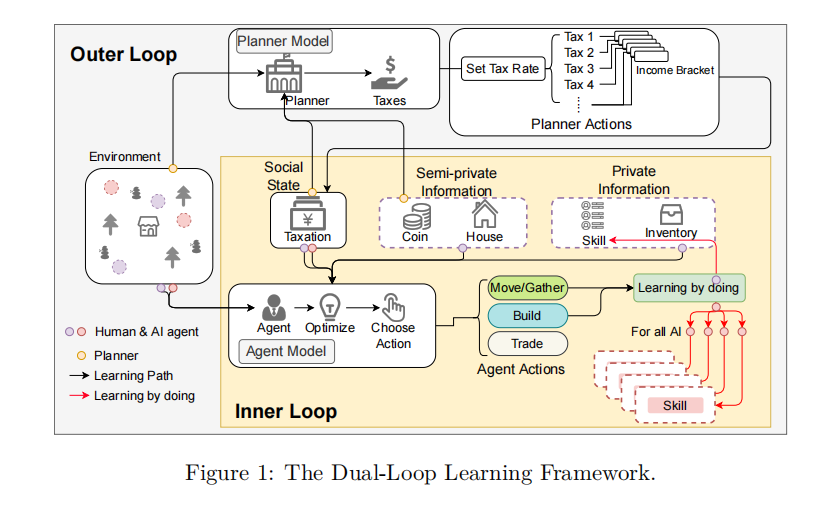
模型将 N 个异质智能体置于 L×L 二维空间网格,网格上随机分布木、石等可再生资源、水域障碍与随机地形。智能体状态包括位置、木石币库存及移动、采集、建造技能,行动包括移动、采集、建造与交易。人类技能随个人经验缓慢积累,AI 每期继承全球技能前沿。内层中,人类与 AI 在给定税制下以深度强化学习最大化自身折现回报;外层中,规划者的政策网络依据产出×平等的福利目标更新状态依赖税率与一次性转移,两层交替迭代,最终输出非线性税率表和相应均衡配置。
构建空间经济
随机生成地形与资源,初始化人类和 AI 智能体的位置、库存与技能向量。
学习个体响应
给定税制后,智能体选择移动、采集、建造与交易,并按各自机制更新技能。
更新规划者政策
外层规划者依据产出×平等的福利目标,更新状态依赖税率和一次性转移。
比较治理制度
改变知识所有权、共享频率和维护份额,比较模型中的产出、平等与福利。
核心创新
- 机制上显式区分人类“干中学”和 AI“集体智能”的学习扩散方式,使替代、极化和不平等动态由模型内生形成,而不是外生设定任务替代率。
- 方法上以双层循环深度强化学习求解高维动态经济中的状态依赖非线性税制,在 AI Economist 范式上加入空间摩擦、内生技能积累与知识扩散。
- 制度上在统一环境中比较所有权与知识共享规则,量化数字公地的模型条件福利,并为机器人税争论提供 U 形边际税率的计算证据。
如何检验,得到了什么结果?
- 模拟环境
- 自建二维空间网格经济,包含随机地形、可再生资源和水域障碍;每回合重新生成地形以检查策略泛化。
- 主体规模
- 基准为 4 名人类与 4 名 AI 智能体的 4H4A 经济,并以 8H 纯人类经济作为对照。
- 政策场景
- 比较无税自由放任、美国联邦所得税、学得最优税制,以及私有/公共所有权与封闭/定期/实时共享的组合。
- 比较对象
- 4H4A_free、4H4A_US、4H4A 与 4H4A_8HTax,以及 No Sharing、Periodic 和 Real-time 等知识共享协议。
- 评估指标
- 社会总产出、1−Gini 平等指标、产出×平等福利、边际税率表、技能演化路径和收入来源分解。
- 训练设置
- 训练 40 万时间步;扩展实验引入 AI 维护份额约束,用于检查数字公地的激励相容性。
验证路径
模拟主体
基准为 4 名人类与 4 名 AI 智能体,并以 8 名人类经济作为对照。
政策场景
比较自由放任、美国联邦所得税、学得最优税制及所有权×共享协议。
评估指标
总产出、1−Gini 平等指标、产出×平等福利、边际税率与技能演化路径。
主要结果
- 生产率与极化:在该模拟中,AI 融入使总产出由约 8,981 增至 11,987,提高 33.5%;但无税时平等指标由 0.72 降至 0.44,出现明显极化。
- 模型内帕累托改进:学得税制下,平等指标回升到 0.95,超过纯人类基准,同时产出保持在 12,699。这是给定环境和福利函数下的模型条件结果,不是现实政策预测。
- U 形最优税率:高收入段对 AI 技术租金征收较高边际税率,中收入段形成税收谷以保留人类劳动激励,低收入段通过较高一次性转移获得补贴。
- 技能动态:AI 技能快速增长并呈现赢者通吃;高技能人类依靠比较优势继续积累,中等技能人类出现内生停滞,低技能人类因为 AI 忽视低附加值部门而相对少受影响。
- 制度比较:公共所有和实时共享在所比较组合中获得最高产出与福利;维护份额过高会侵蚀再分配能力,过低则导致维护激励崩溃。
图表与证据
代表图
展示规划者外层学习和人类/AI 智能体内层学习的双层循环。
税收政策与个体响应是在同一模拟中交替学习的。Figure 5
比较人类与 AI 在多项技能上的积累路径。
人类个人经验与 AI 集体智能的差异内生产生技能分化。Table 1
汇总各税收与知识制度场景下的产出、平等与福利。
学得税制和数字公地的优势只在该模型与福利目标下成立。这项工作意味着什么?
主要贡献
- 机制贡献:显式建模人类与 AI 的学习扩散不对称,内生产生中等技能替代、收入极化与不平等上升。
- 方法贡献:扩展双层 MARL,在高维动态经济中联合求解个体响应和状态依赖的非线性税收政策。
- 政策机制贡献:在受控环境中得到 U 形边际税率,并展示税收如何在模型内把技术红利转化为效率与平等的同步改善。
- 制度贡献:比较所有权、接入和共享频率,识别公共所有、通用接入和实时共享组成的数字公地及其维护激励边界。
总结
该工作构建了具有内生技能积累与知识扩散的空间多智能体经济,用双层循环强化学习同时求解政府税收政策和人类、AI 智能体的行为响应。模型结果显示,AI 提高总产出但加剧收入极化,U 形税率能够在作者设定的福利目标下改善效率与平等;公共所有和实时共享构成的数字公地在制度比较中表现最佳。这一框架适合研究机制和条件性反事实,但不能直接给出现实最优税率或因果政策结论。
模拟抽象了金融部门、资本积累、完整价格体系、内生创新和政治经济约束,且基准仅含 8 个智能体。所有政策结论依赖福利函数与有界理性设定,应视为定性机制启示。