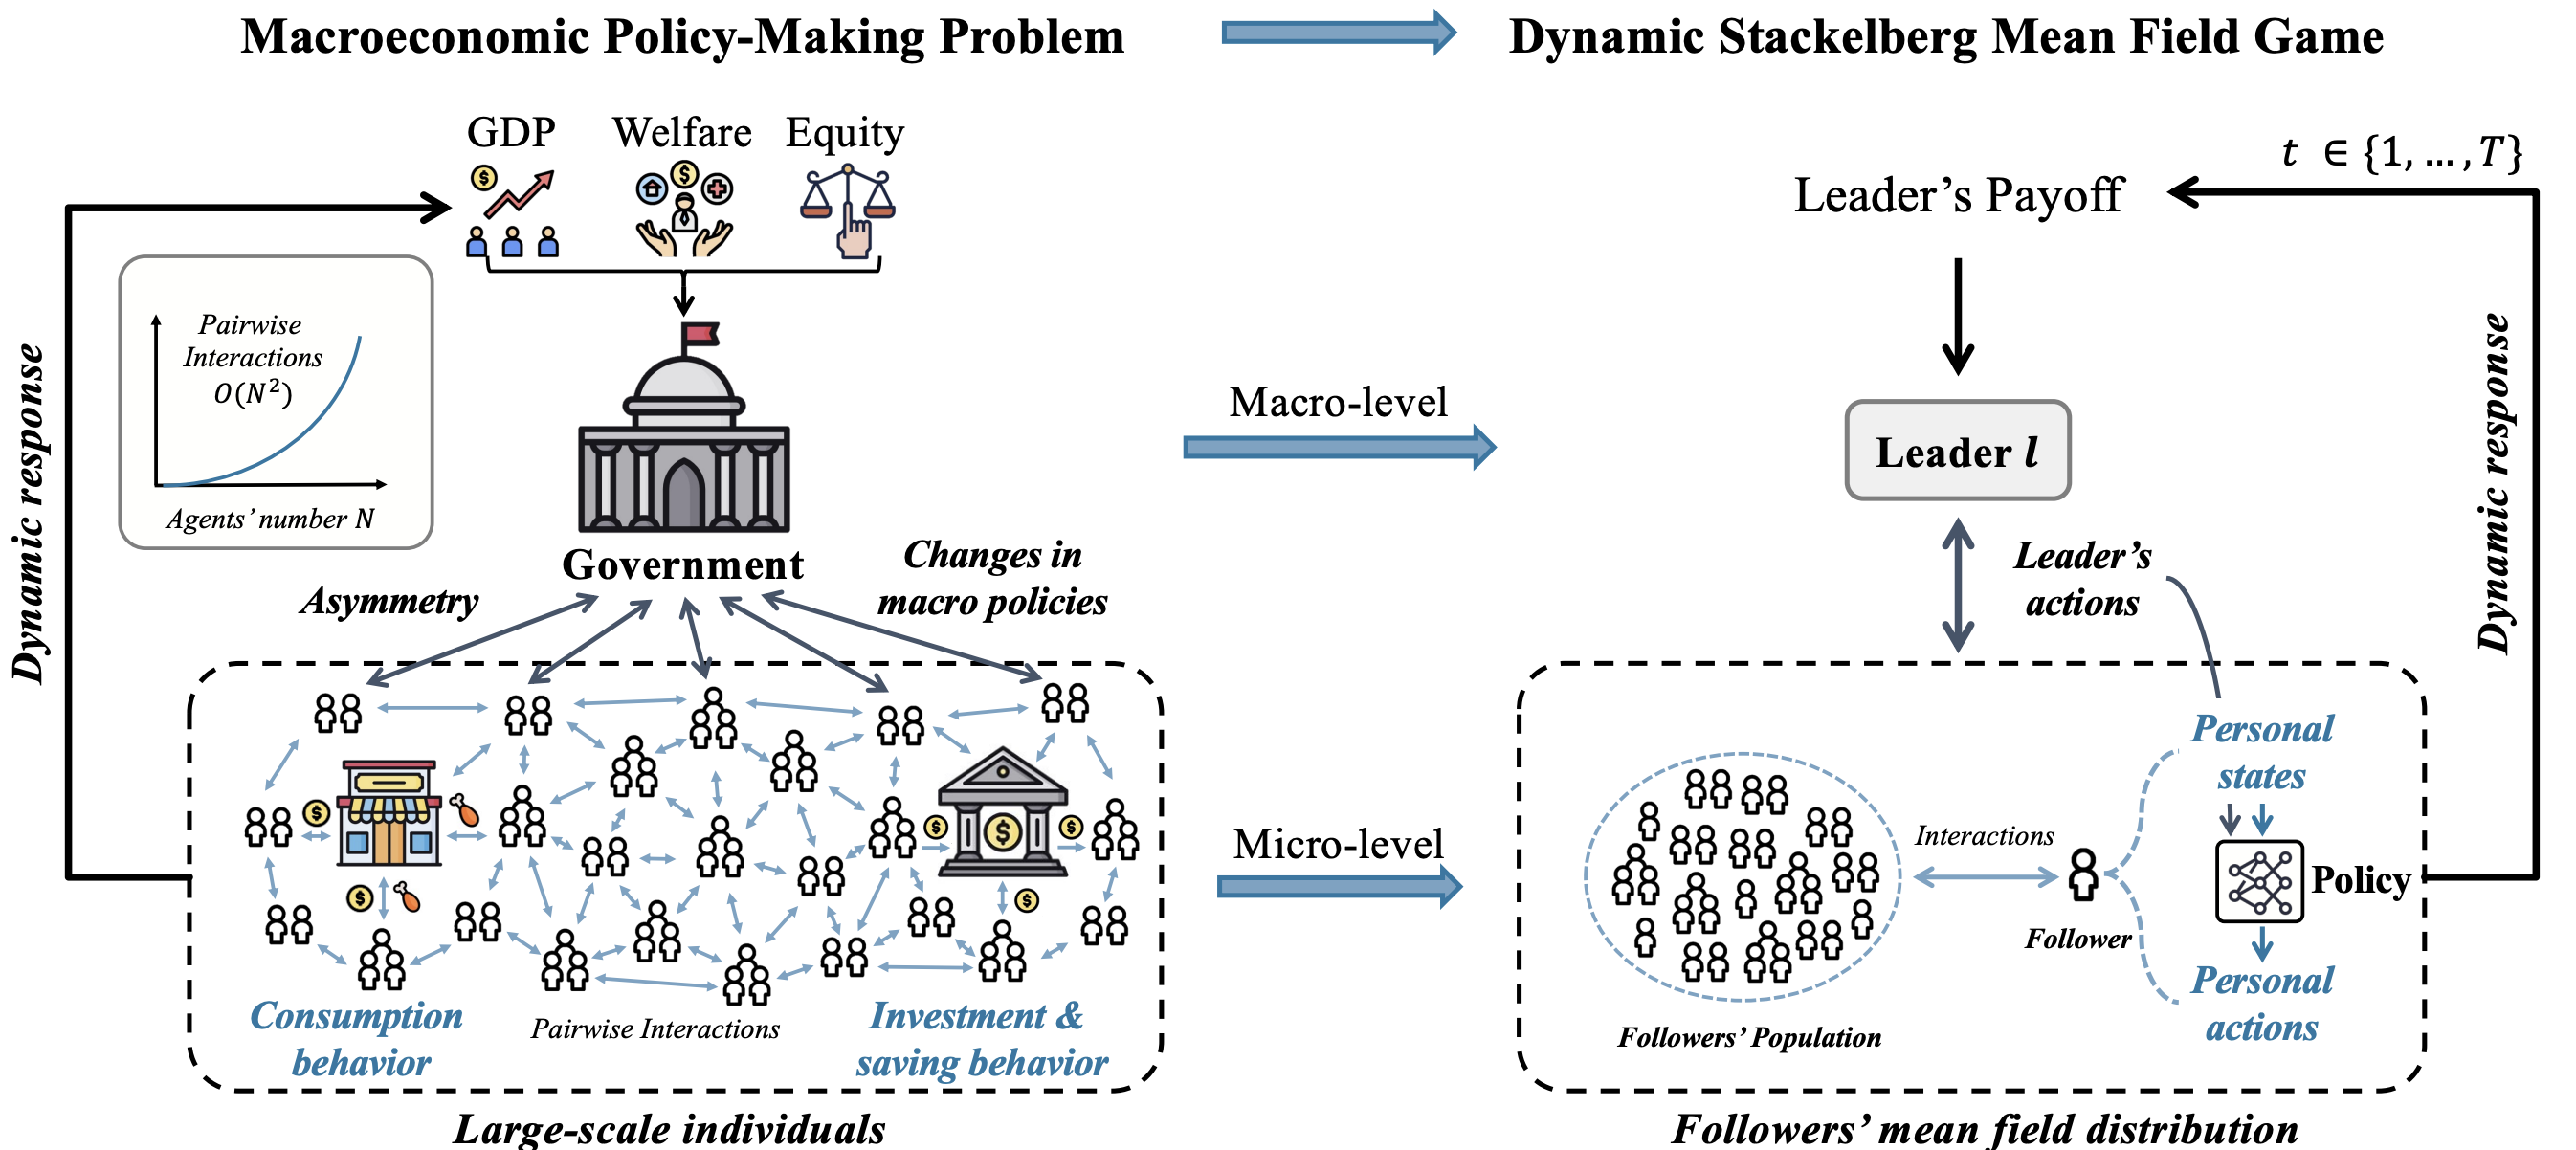
这项研究试图解决什么问题?
研究背景
宏观政策学习需要同时处理时间上的动态反馈、政府与个体之间的层级不对称,以及大规模主体带来的计算负担。三者若分开处理,难以表达政策与个体行为的联合演化。
核心问题
如何同时处理宏观政策制定中的动态反馈、政府与个体之间的不对称关系,以及大规模主体交互。
具体研究内容
- 统一建模动态反馈、层级不对称性与大规模主体。
- 通过均值场近似将交互计算复杂度由约 O(N²) 降至 O(N)。
- 设计 SMFRL,在共享策略的同时保留由异质状态产生的个性化行为。
研究是怎样完成的?
DSMFG 将个体间两两交互替换为个体与群体分布的交互;SMFRL 通过政府和个体策略的交替更新学习层级博弈政策。
层级博弈
将政府表达为领导者、异质个体表达为跟随者,保留政策制定的不对称性。
均值场近似
以个体与群体分布的交互替代两两交互,将交互复杂度由约 O(N²) 降至 O(N)。
SMFRL 求解
交替更新政府与个体策略,在共享策略中保留异质状态所产生的个性化行为。
如何检验,得到了什么结果?
验证路径
受控环境
实验依托 TaxAI 经济模拟器,用于隔离并检查层级政策学习机制。
主体规模
论文实验扩展至 1,000 个主体,并检查均值场近似下的计算可扩展性。
政策基线
将学得政策与 Saez 方法及静态联邦税收基线比较,所有倍数均限于该模拟设定。
主要结果
- 论文在 TaxAI 受控模拟中扩展到 1,000 个主体;在特定环境、目标函数和基线设置下,报告人均 GDP 相对 Saez 税收方法约为 4 倍,相对 2022 年美国静态联邦税收基线约为 19 倍。
这项工作意味着什么?
主要贡献
- 统一建模动态反馈、层级不对称性与大规模主体。
- 通过均值场近似将交互计算复杂度由约 O(N²) 降至 O(N)。
- 设计 SMFRL,在共享策略的同时保留由异质状态产生的个性化行为。
总结
DSMFG 说明,宏观政策学习可以同时保留政府与个体之间的层级关系,并用均值场近似控制大规模交互成本。其主要方法意义在于把政策制定者和异质主体的响应放进同一个动态求解过程。
如何理解结果
上述倍数仅是特定 TaxAI 环境、目标函数和基线设置下的模拟结果,不代表真实美国政策实施后 GDP 会产生相应变化。