研究概览
动态规划是宏观经济分析的基础求解工具,却长期受制于维度灾难。该工作研究如何把深度强化学习用于经济动态模型的高维最优控制,同时不丢弃已知的经济结构。其核心是提出“知情演员–评论家”(iAC)框架:保留演员–评论家的分离式更新结构,将 Q 函数评论家替换为价值函数评论家,并把贝尔曼目标、转移方程、可行性约束与均衡映射等模型结构直接嵌入策略优化回路。在标准消费–储蓄基准上,iAC 的消费政策平均百分比误差仅 0.27%、最大 0.72%,接近高精度网格参考解;在 Krusell–Smith 与代际交叠(OLG)经济中的应用进一步表明,该方法比模型无关的演员–评论家基线数值误差更低、训练更稳定、样本效率更高。
这项研究试图解决什么问题?
研究背景
传统动态规划依赖网格离散化,随状态变量增多计算量呈指数增长。Krusell–Smith 矩近似、局部扰动法、稀疏网格与投影插值等方法都不能消除“模型越丰富越难解”的基本权衡,尤其是在多状态变量、非线性约束与一般均衡反馈并存时。强化学习虽然提供了成熟的连续控制工具,但主流模型无关方法把经济当作黑箱,忽略大量已知方程,不得不从模拟数据中重新学习既有结构,因而信息利用效率低、依赖探索噪声且训练不稳定。
计算经济学家能否使用深度强化学习求解大型动态经济模型,同时不丢弃贝尔曼方程、状态转移、可行约束与均衡对象等已知结构?
具体研究内容
- 系统比较 Q-learning、演员–评论家、软目标、经验回放与模型信息等设计,识别经济动态求解中的信息缺口。
- 提出价值函数评论家与已知转移方程相结合的 iAC,并给出局部收缩性与隐式行动价值对象的正式论证。
- 把同一训练逻辑扩展到消费–储蓄、Krusell–Smith 与 OLG 模型,检验跨模型可移植性。
研究是怎样完成的?
iAC 把无限期动态经济问题写成递归贝尔曼形式,用两个深度神经网络分别参数化策略函数(演员 πθ)与价值函数(评论家 Vω)。前向阶段冻结演员,用模型方程构造单步贝尔曼目标 y = u(s,π(s)) + βE[V(s′)],最小化演员条件贝尔曼残差;后向阶段冻结评论家,对策略参数做梯度上升以最大化期望价值。与模型无关的演员–评论家不同,iAC 不通过状态–动作 Q 表或纯环境交互学习,而是把已知的效用、转移、可行性与均衡方程作为训练脚手架,使梯度经转移映射穿透进入延续价值,最终输出可直接查询的连续策略函数与价值函数。
递归化经济问题
明确状态、行动、可行集、外生冲击和转移方程,把动态模型写成贝尔曼形式。
更新价值评论家
冻结演员,用模型方程构造单步贝尔曼目标并最小化演员条件贝尔曼残差。
改进连续策略
冻结评论家,对演员做梯度上升;梯度经已知状态转移进入延续价值。
交替至均衡
交替更新策略与价值;在异质主体模型中进一步配合总量信念和价格函数更新。
核心创新
- 以“价值函数评论家 + 已知转移方程”取代 DDPG 的 Q 函数评论家。论文通过 Proposition 1 说明,已知支付与转移方程可以由价值评论家诱导出单步行动价值对象,从而保留策略改进所需的信息,同时避免高维状态–动作空间的密集覆盖与最大化。
- 把贝尔曼目标、可行性约束与均衡映射直接嵌入梯度传播,消除模型无关方法为了重新发现已知结构而使用的探索噪声。
- 相较 DeepHAM 等深度贝尔曼方法,iAC 保留演员–评论家的策略改进机制与连续控制优势,并让同一训练逻辑可以跨消费–储蓄、Krusell–Smith 与 OLG 模型移植。
如何检验,得到了什么结果?
- 模型环境
- 标准消费–储蓄模型(含借贷约束);两状态马尔可夫冲击与 AR(1) 总冲击的 Krusell–Smith 经济(含不可分劳动扩展);简单 OLG 经济。
- 研究对象
- 消费–储蓄基准为单一主体;Krusell–Smith 为异质主体连续统,数值模拟使用 50 个主体。
- 实验任务
- 求解最优储蓄与消费政策,检验贝尔曼期望残差与局部最优性误差,并比较稳态财富分布和总冲击模拟路径。
- 比较方法
- 高精度 VFI、Q-learning、Dyna-Q、DQN、SAC,以及 Maliar et al. (2021) 的 DeepHAM Bellman/Euler 实现。
- 评估指标
- 消费政策平均/最大百分比误差、价值函数 RMSE 与最大绝对误差、贝尔曼误差、R²、财富 Gini、Corr(c,y) 和运行时间。
- 其他设置
- CRRA 效用、β∈(0,1)、多采样期望构造;附录进一步比较全批次与随机采样、网格密度和学习动态。
验证路径
模型环境
标准消费–储蓄模型、两状态与 AR(1) 总冲击的 Krusell–Smith 经济,以及简单 OLG 经济。
比较基线
高精度 VFI、Q-learning、Dyna-Q、DQN、SAC,以及 DeepHAM 的 Bellman/Euler 实现。
验证指标
政策误差、价值函数误差、贝尔曼期望与局部最优性误差、R²、经济矩及运行时间。
主要结果
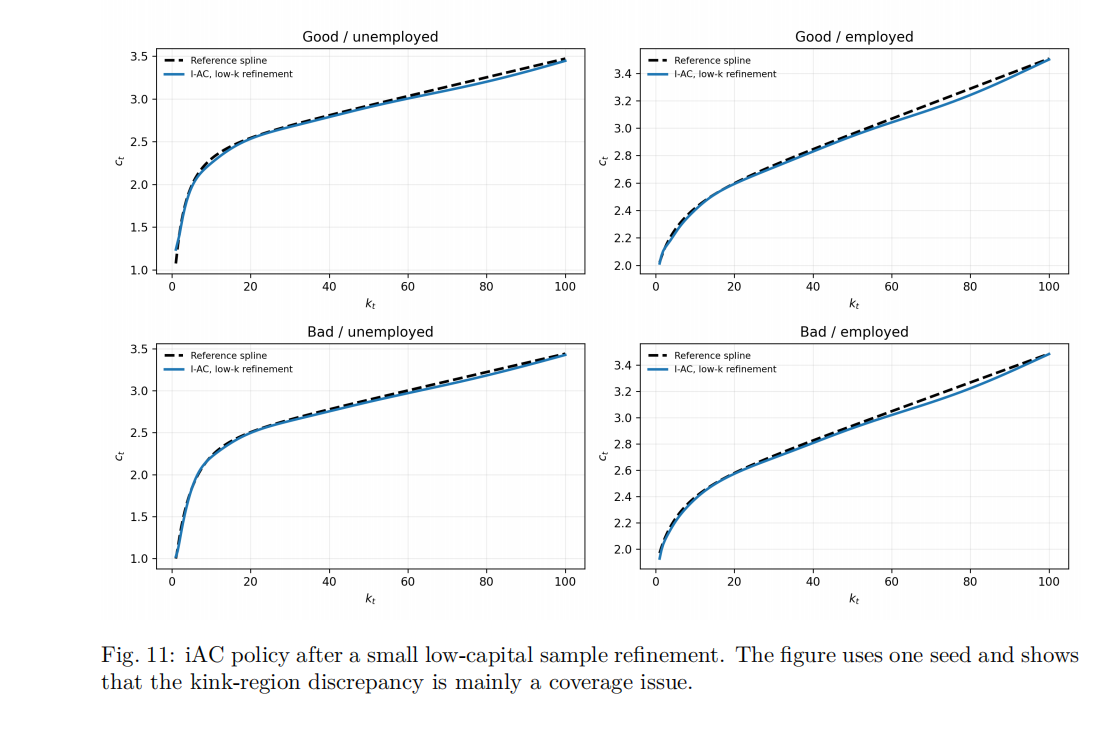
- 消费–储蓄基准:相对 2000×100×2000 网格 VFI 参考解,iAC 的消费政策平均百分比误差为 0.27%、最大误差为 0.72%;价值函数 RMSE 为 1.1×10⁻²,最大绝对误差为 3.1×10⁻²。
- 信息缺口消融:DQN、SAC 等模型无关方法的效率低于使用已知模型方程的方法,说明忽略经济模型结构意味着从模拟数据中重新学习过多信息。
- 两状态 Krusell–Smith:iAC 的贝尔曼期望误差 MAE 为 0.00779、最优性误差为 0.00814,均低于 DeepHAM 的 0.01303 与 0.01512;训练时间 4,740 秒,约为 DeepHAM 9,660 秒的一半。
- AR(1) Krusell–Smith:iAC 的 R² 为 0.996741,高于 Bellman 实现的 0.992532 与 Euler 实现的 0.9898;贝尔曼期望误差为 0.010502,低于 Bellman 实现的 0.026395;财富 Gini 为 0.4565,与 Euler 实现的 0.447 接近。
- 稳健性检查中,不同随机初始化得到相近的政策函数与稳态结果,演员和评论家损失在前期波动后趋于稳定;这降低了对单一有利初始化的担忧,但不构成全局收敛证明。
图表与证据
代表图
展示 iAC 的代表性求解结果。
方法在所测试模型中同时追求较低数值误差与稳定训练。Figure 13
比较两状态 Krusell–Smith 在共同总冲击下的总资本路径,包括参考样条、iAC 与 DeepHAM。
聚合路径接近参考解,但仍需政策函数、分布和局部贝尔曼误差共同验证。Table 4 / 5
汇总两状态和 AR(1) Krusell–Smith 的贝尔曼验证、经济矩与训练时间。
iAC 在更短训练时间内取得更低贝尔曼误差,并复现关键经济矩。这项工作意味着什么?
主要贡献
- 提出 iAC 框架,把贝尔曼方程、转移方程、可行约束和均衡对象嵌入深度演员–评论家训练,减少探索噪声。
- 通过 Q-learning、VFI、Dyna-Q、DQN 与 SAC 的系统消融刻画“信息缺口”,为经济模型中的强化学习设计选择提供证据。
- 以价值函数评论家和隐式行动价值对象避免高维动作空间中的 Q 最大化,并给出局部贝尔曼算子收缩性等正式结果。
- 展示同一训练逻辑可移植到两类 Krusell–Smith、不可分劳动扩展与 OLG 经济,并在更短运行时间下取得更低贝尔曼误差。
总结
该工作提出“知情演员–评论家”方法,把深度强化学习的连续控制能力与经济模型的已知结构结合起来,缓解传统网格动态规划的维度灾难和模型无关强化学习的低效探索。iAC 在消费–储蓄基准中接近高精度参考解,并在 Krusell–Smith 与 OLG 经济中以更短训练时间取得更低贝尔曼误差,为后续发展结构知情的神经经济求解器提供了可迁移的训练逻辑。
实验仍限于消费–储蓄、Krusell–Smith 与简单 OLG 等标准模型;理论结果依赖紧凑计算域、可微性与固定训练状态分布等条件,刻画局部改进而非全局收敛。