这项研究试图解决什么问题?
研究背景
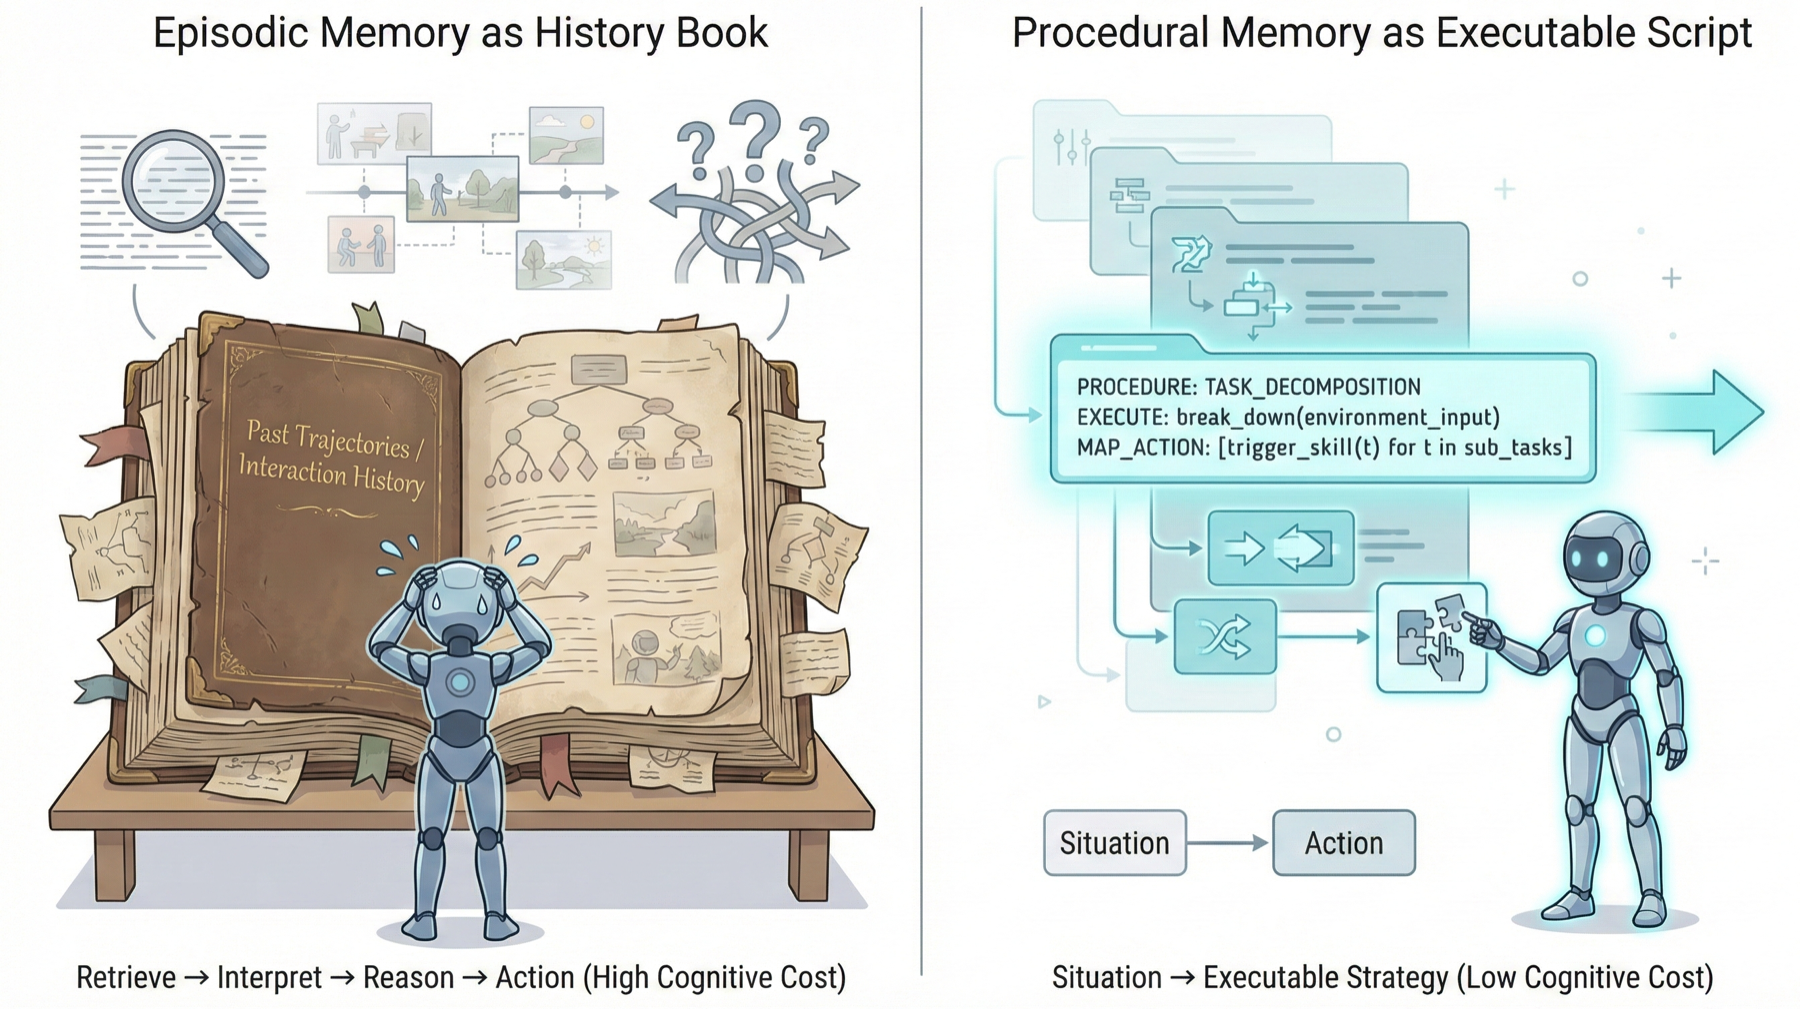
以情节记忆为主的智能体常把历史轨迹当作需要临场翻阅的“历史书”:即使面对相似情境,仍需重复检索、解释与推演。Skill-Pro 希望将这些经验沉淀为可直接执行的程序化技能。
核心问题
如何把零散的交互轨迹转化为可直接调用的程序化技能,减少相似任务中的重复推演与执行不稳定。
具体研究内容
- 以启动条件、策略和终止条件三部分结构定义可复用技能。
- 提出无需参数更新的 Non-Parametric PPO,在文本空间中迭代优化技能。
- 建立覆盖生成、验证、评分、精炼与淘汰的技能全生命周期演化机制。
研究是怎样完成的?
以 Skill-MDP 表征技能,通过语义梯度进行候选技能生成和事后归因,并使用 PPO Gate 与在线评分机制持续验证、精炼或剔除技能。
Skill-MDP 表征
将技能表达为启动条件、可执行策略与终止条件,连接具体情境和动作。
Non-Parametric PPO
不更新基础模型参数,而是用语义梯度和事后归因在文本空间中优化技能。
全生命周期演化
PPO Gate 和在线评分机制持续验证、精炼或淘汰技能,使技能库随经验自适应更新。
如何检验,得到了什么结果?
验证路径
交互式基准
在 ALFWorld 等交互任务中检查技能学习后的任务完成能力。
复用性
将学得技能迁移到新任务与不同智能体,检查其是否超越单次轨迹检索。
效率与成功率
项目材料报告约 816 个 Token 的核心技能表达,以及 ALFWorld 设置下 0.90 的成功率。
主要结果
- 论文与项目材料报告,Skill-Pro 在跨任务和跨智能体设置中表现出较高复用率;约 816 个 Token 即可维持核心技能逻辑,并在 ALFWorld 相关实验中达到 0.90 的成功率。
这项工作意味着什么?
主要贡献
- 以启动条件、策略和终止条件三部分结构定义可复用技能。
- 提出无需参数更新的 Non-Parametric PPO,在文本空间中迭代优化技能。
- 建立覆盖生成、验证、评分、精炼与淘汰的技能全生命周期演化机制。
总结
Skill-Pro 的核心思想是把智能体过去的交互轨迹压缩为可直接执行的程序化技能,使智能体在相似情境中不必重新进行完整推演。现有结果展示了这种非参数记忆更新方式的效率与迁移潜力。
如何理解结果
这些结果来自指定交互式基准、模型与评估设置,说明程序化技能机制在相应任务中的效果,但不能直接推出开放世界中的长期自主性或普遍可靠性。