研究概览
离散–连续动态选择(DCDC)模型广泛存在于劳动经济学、产业组织与宏观经济学中,其价值函数是各选择分支的上包络,在离散切换处形成不可微拐点,使传统网格方法与端到端深度学习分别陷入维度灾难或梯度截断。该工作提出软到硬(StH)深度强化学习框架:训练时以 log-sum-exp 软延续值与 logistic 软选择概率替代硬离散开关,让梯度穿透价值分支与策略网络;温度参数随迭代系统退火至零,评估时回到严格的硬开关决策,从而求解原始、未平滑的经济体。在一期与多期 CE2012 主权违约模型上的应用表明,StH 即使从严重失真的初始化出发,也能恢复违约边界与资产政策,其模拟矩与 CE2012 目标高度接近。
这项研究试图解决什么问题?
研究背景
DCDC 模型的传统求解路线依赖昂贵的全局网格搜索,如 VFI、DCEGM 与 MPEC,维度限制严重。另一条路线通过永久引入辅助收入冲击、极值偏好冲击或随机到期结构平滑环境,虽然便于计算,却改变经济体的结构原语,可能扭曲反事实政策含义。已有直接求解原始问题的方法又常依赖模型专属的广义欧拉方程推导和离散网格。对深度学习而言,硬 max 在切换处不可微,训练早期落后分支获得零梯度,网络因失去关键信号而停滞。
能否使用深度强化学习直接求解原始、未平滑的离散–连续动态选择模型,既绕过动作网格,又不依靠永久平滑装置改变经济结构?
具体研究内容
- 形式化一般二元离散选择与连续行动并存的 DCDC 环境,解释硬 max 导致的梯度消失。
- 设计四网络 StH 求解器,并证明软算子随温度下降一致逼近硬选择结构。
- 在一期主权违约模型中恢复违约边界、债券价格和资产政策,并进行严重失真初始化测试。
- 在多期 CE2012 长期债务模型中比较无永久平滑、辅助收入冲击和品味冲击三类求解对象。
研究是怎样完成的?
StH 用四个神经网络分别表示连续策略 xω(s)、还款与违约两个分支的价值评论家 V¹θ、V⁰ψ,以及均衡期望网络 Γφ(例如债券价格函数)。连续策略经过 sigmoid 有界参数化以满足可行域。训练时,以 Cτ(s)=τ·lnΣexp(Vd/τ) 的 log-sum-exp 软延续值替代硬 max,并以 logistic 软还款概率替代硬指示函数,使两个价值分支与连续演员始终获得非零梯度;温度 τ 随迭代单调退火至零。评估和模拟时则移除所有平滑装置,由演员在原始硬开关经济中输出确定性行动。
写出分支价值
把 DCDC 问题写成各离散分支的连续优化及其上包络,并明确递归定价等均衡条件。
软化训练信号
用 log-sum-exp 延续值与 logistic 选择概率构造贝尔曼回归和演员更新,让梯度穿透所有分支。
系统温度退火
将温度单调降至零,使训练目标逐渐逼近原始的硬 max 与硬指示函数。
回到硬经济评估
冻结网络并移除平滑,模拟原始经济的违约、债务、价格和利差路径。
核心创新
- 相较永久性品味冲击与 CE2012 辅助收入冲击,StH 只在训练阶段使用平滑;最终评估求解原始无冲击经济体,因此把数值优化需要与经济结构严格分开。
- 相较交叉熵式分类框架,退火温度被直接嵌入连续延续价值,使梯度能够穿透全部价值分支,并适用于连续政策和递归定价内生的一般 DCDC 问题。
- 相较依赖广义欧拉方程的模型专属方案,神经网络函数逼近绕开了动作网格和专门解析推导,形成可扩展的连续行动架构。
如何检验,得到了什么结果?
- 模型环境
- 一期主权违约模型(λ=1 特例)与采用 CE2012 原始参数校准的长期债务模型,后者包含债务稀释与递归定价。
- 研究对象
- 单个主权政府构成的小型开放经济,收入冲击服从离散马尔可夫过程。
- 实验任务
- 恢复违约边界、债券价格、利差函数与债务政策;比较长期模拟矩,并包含严重失真初始化的稳健性实验。
- 比较方法
- 一期模型网格参考解、CE2012 辅助收入冲击基准,以及同校准下的品味冲击/logit 基准。
- 评估指标
- 政策函数贴合度、债券价格与利差曲线、平均利差、利差标准差、债务产出比、违约频率及消费/利差与产出的相关性。
- 其他设置
- 温度按预设进度退火,sigmoid 激活保证连续政策位于可行域;软训练目标与硬评估严格分离。
验证路径
应用环境
一期 Eaton–Gersovitz / Arellano 型模型,以及采用 CE2012 校准的长期债务模型。
比较对象
一期网格参考解、CE2012 辅助收入冲击基准,以及同校准的品味冲击/logit 基准。
验证对象
违约边界、债券价格、资产政策、模拟利差、债务产出比、违约频率与相关性矩。
主要结果
- 一期模型中,StH 精确恢复硬违约边界、价格函数与资产政策;在严重失真初始化下,训练虽然一度停滞,但软延续值继续给非最优分支分配梯度,最终逃离局部陷阱并回到基准。
- 神经网络能够高精度重构 CE2012 的价格函数、利差曲线、违约区域与债务收入诊断,和原始 MATLAB 复现包输出的目标曲线紧密对齐。
- 多期 CE2012 硬评估中,平均利差为 0.0875(目标 0.0815)、利差标准差为 0.0486(目标 0.0443)、债务产出比为 0.6997(目标 0.7000)、违约频率为 0.0745(目标 0.0680)。
- 相关性矩同样接近目标:Corr(C,Y) 为 0.9847(目标 0.99),Corr(Spread,Y) 为 −0.6611(目标 −0.65)。
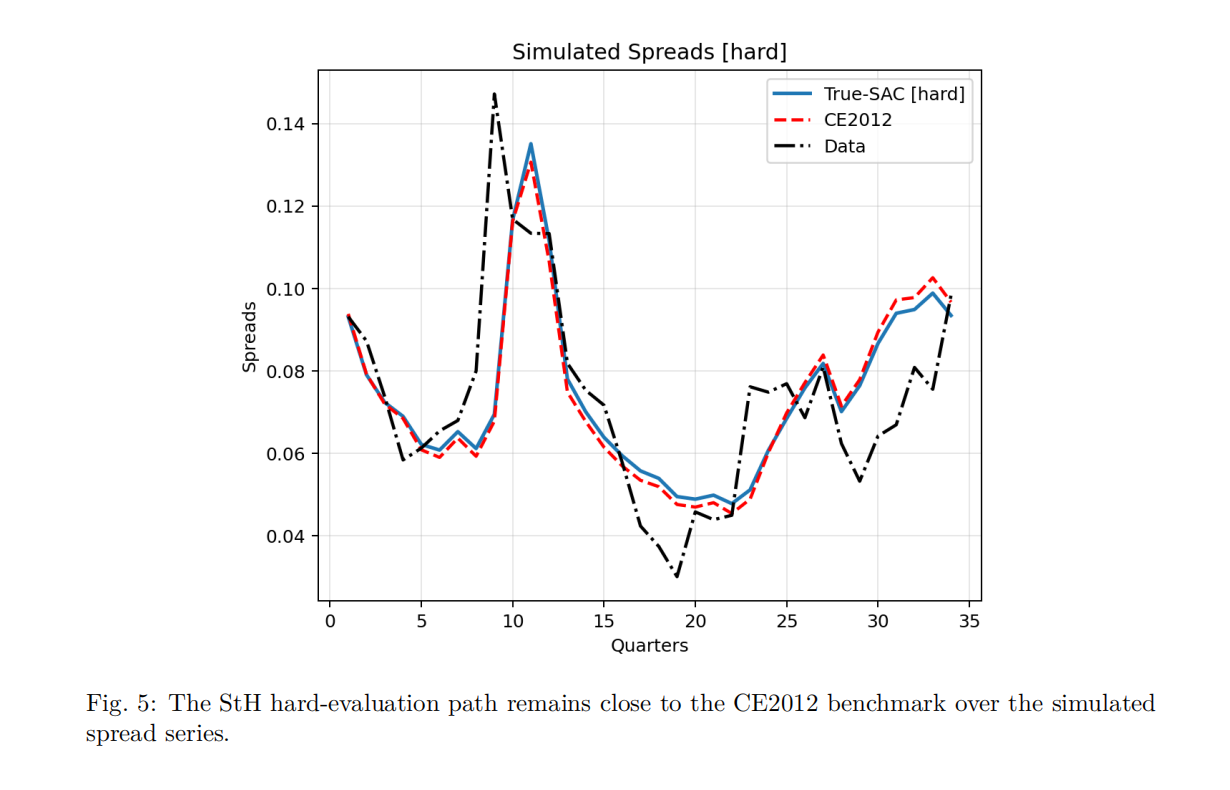
- 品味冲击/logit 基准在中高收入状态下与其他解接近,但会在低收入状态显著移动违约区域;StH 的利差时间序列则在硬评估下与 CE2012 基准路径紧密吻合。
图表与证据
代表图
展示 StH 在主权违约模型中的代表性硬评估结果。
训练中的软化并未被永久写入最终经济模型。Figure 3
展示移除全部平滑装置后的长期模型连续行动演员–评论家解。
无需全局动作网格搜索,也能复现长期债务经济的核心均衡对象。Table 1
逐项比较 CE2012 目标矩与 StH 最终硬评估矩。
两者差异总体较小,同时保留了对结构性平滑影响的辨析。这项工作意味着什么?
主要贡献
- 把训练所需的数学平滑与经济体的结构原语解耦。
- 提供无需全局动作网格的连续行动 DCDC 求解架构。
- 量化永久平滑装置对违约边界和模拟矩的影响。
- 建立从一期机制验证到长期债务硬评估的证据链。
总结
该工作提出软到硬深度强化学习求解器,通过“训练时软、评估时硬”的温度退火设计解决 DCDC 模型在硬切换处的梯度消失问题,并在不引入永久性品味冲击、辅助收入冲击或随机到期假设的前提下求解原始主权违约经济。它消除了全局动作网格搜索,也量化了传统平滑装置导致的解偏移,为违约时机、利差和福利计算敏感的数量经济学问题提供了一条新的计算路径。
当前应用集中于主权违约;训练依赖温度退火等超参数,缺少系统敏感性分析;复现包尚未公开,第三方独立复核仍待完成。