- 识别研究环境、主体表示、求解方法和验证证据
- 区分RL最优化主体与LLM情境化主体
- 按单主体、多主体和分层政策问题选择算法
- 建立可复现的多层验证与误差归因
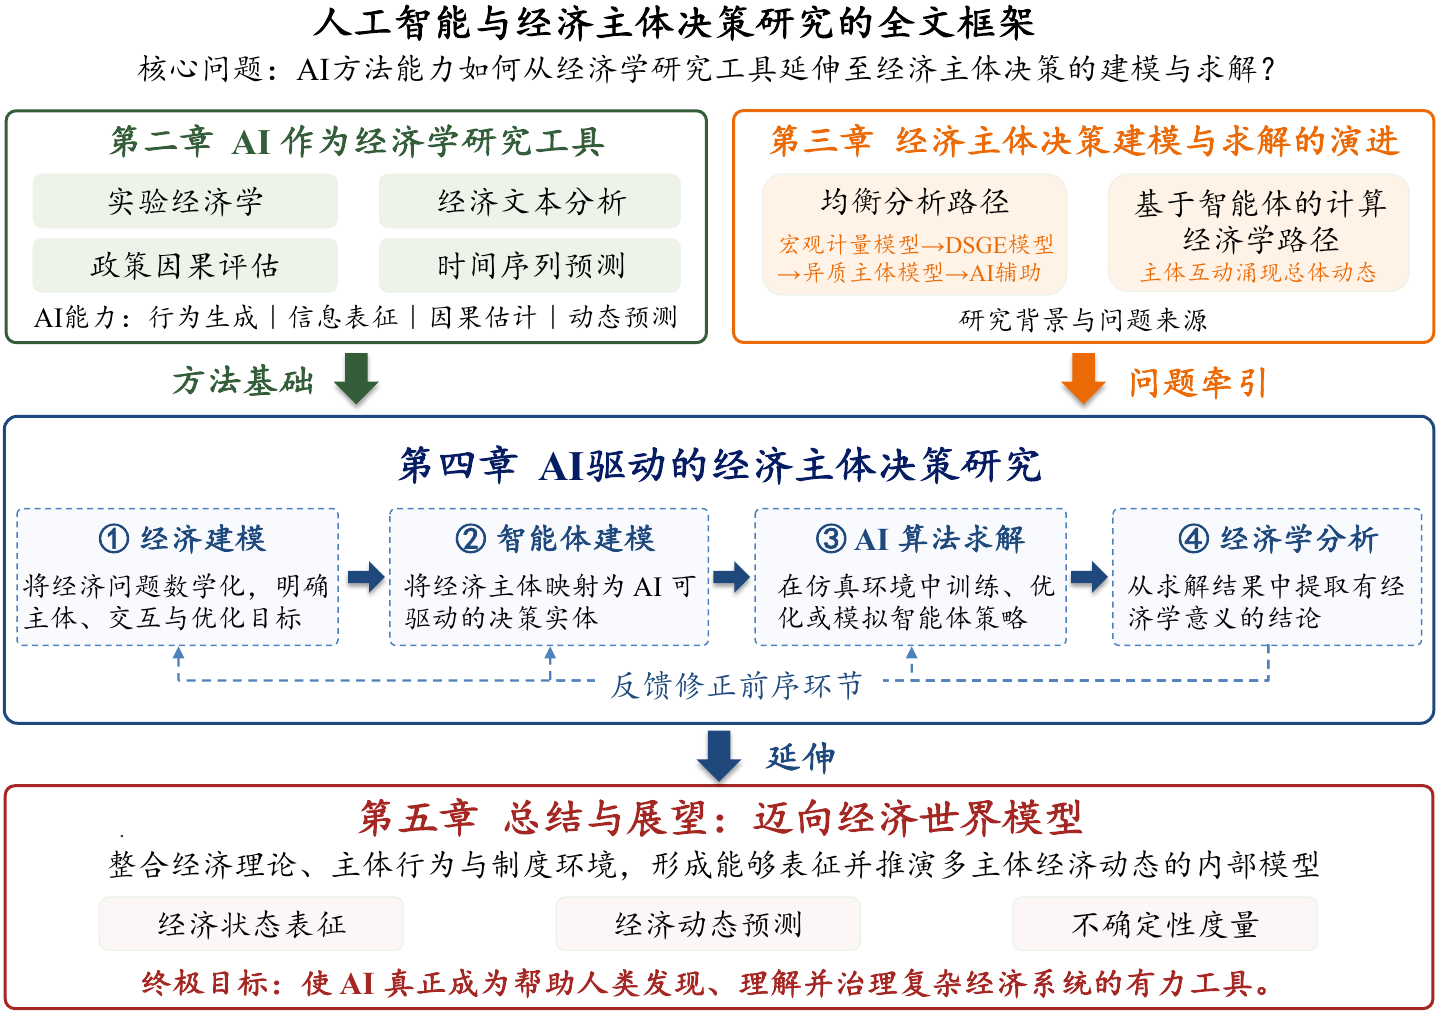
四个环节构成一个反馈闭环
经济建模决定主体、资源、制度和交互边界;智能体建模把经济角色转化为观测、行动、目标与内部状态;算法求解产生策略或行为;分析与验证再判断结果是否满足经济约束并对应现实证据。
验证失败可能来自环境、主体表示或训练过程,因此研究流程必须允许返回前序环节,而不是一次性的算法流水线。
这个框架把分散在税收政策、市场竞争、消费储蓄和社会模拟中的研究放到同一套可追问的流程里:问题如何被形式化,主体如何被编码,策略如何被生成,结论又由什么证据支持。
第一步不是选算法,而是完整定义经济问题
经济建模至少需要明确三类要素:谁是决策主体,哪些结构方程决定系统演化,以及每类主体在什么约束下优化什么目标。一个完整定义应让读者能回答资源如何流动、价格如何形成、制度如何约束行为,以及状态如何从本期转移到下期。
传统建模的产物常是一组待解方程;在AI智能体范式下,这些要素要进一步转化为可计算、可交互的仿真环境:结构方程成为状态转移,优化目标成为决策问题,经济约束成为环境强制执行的边界。
Step 1:构建经济环境
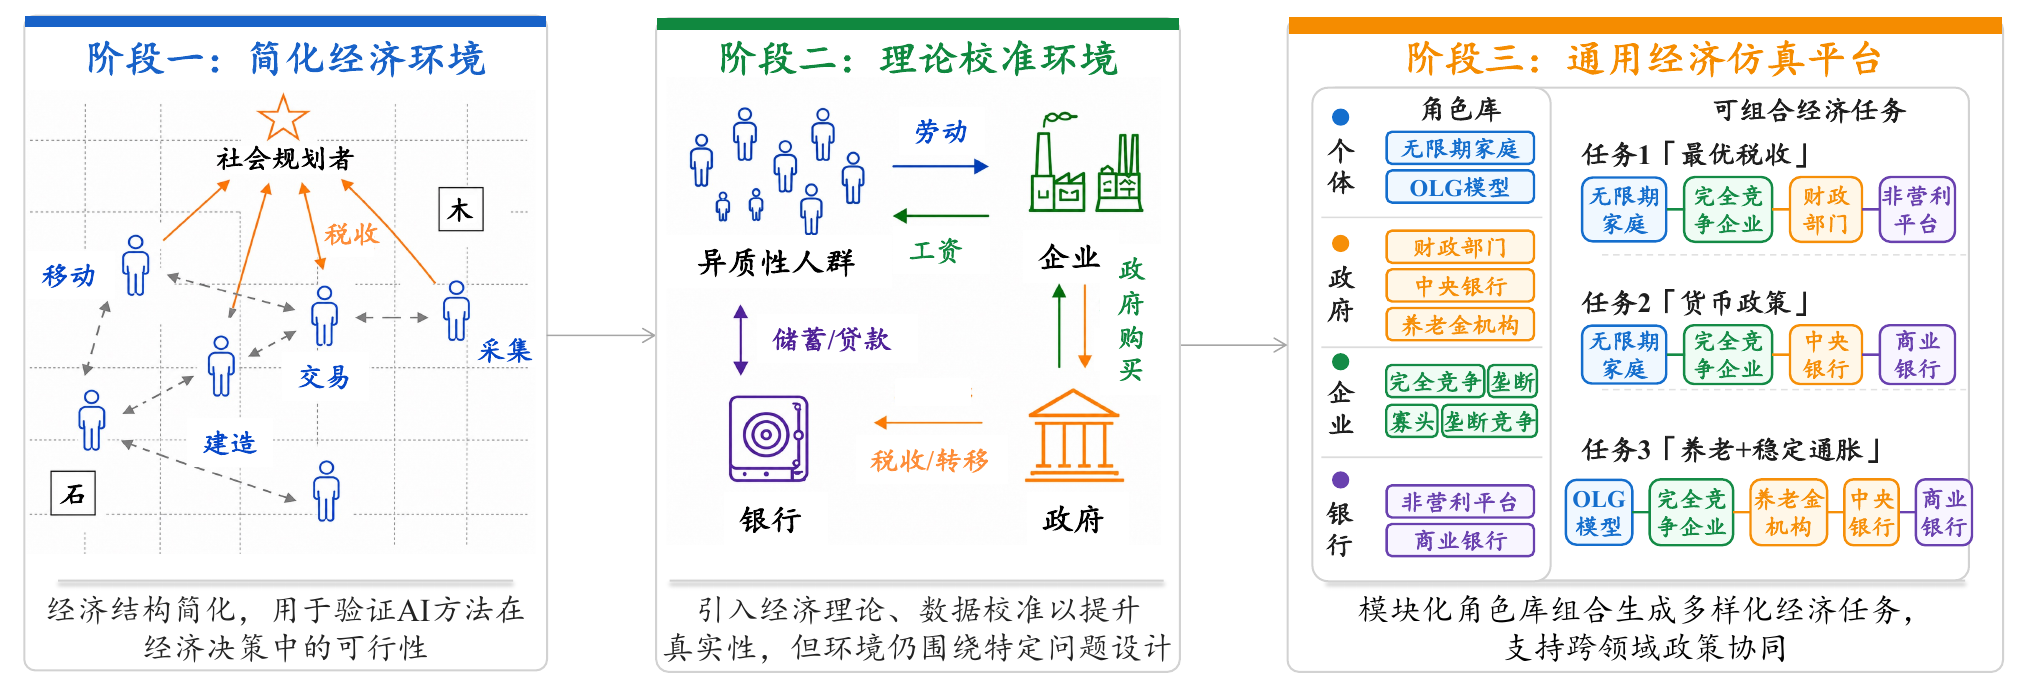
简化环境适合隔离机制和验证算法;理论校准环境把成熟经济模型转化为可交互系统;通用平台则通过角色、任务和算法接口支持多领域组合。
无论复杂度如何,研究者都应明确状态、行动、转移、资源约束、市场机制和制度规则。环境越通用,模块组合后的经济一致性越需要单独验证。
这三个阶段不只代表环境变得更大。AI Economist类简化环境重在验证双层政策学习是否可行;TaxAI等理论校准环境引入不完全市场、家庭异质性和多部门交互;EconGym类通用平台则进一步要求角色能复用、接口能组合,并使税收、货币、养老和市场竞争等机制在共享经济变量上发生联动。
Step 2:把经济角色转化为计算主体
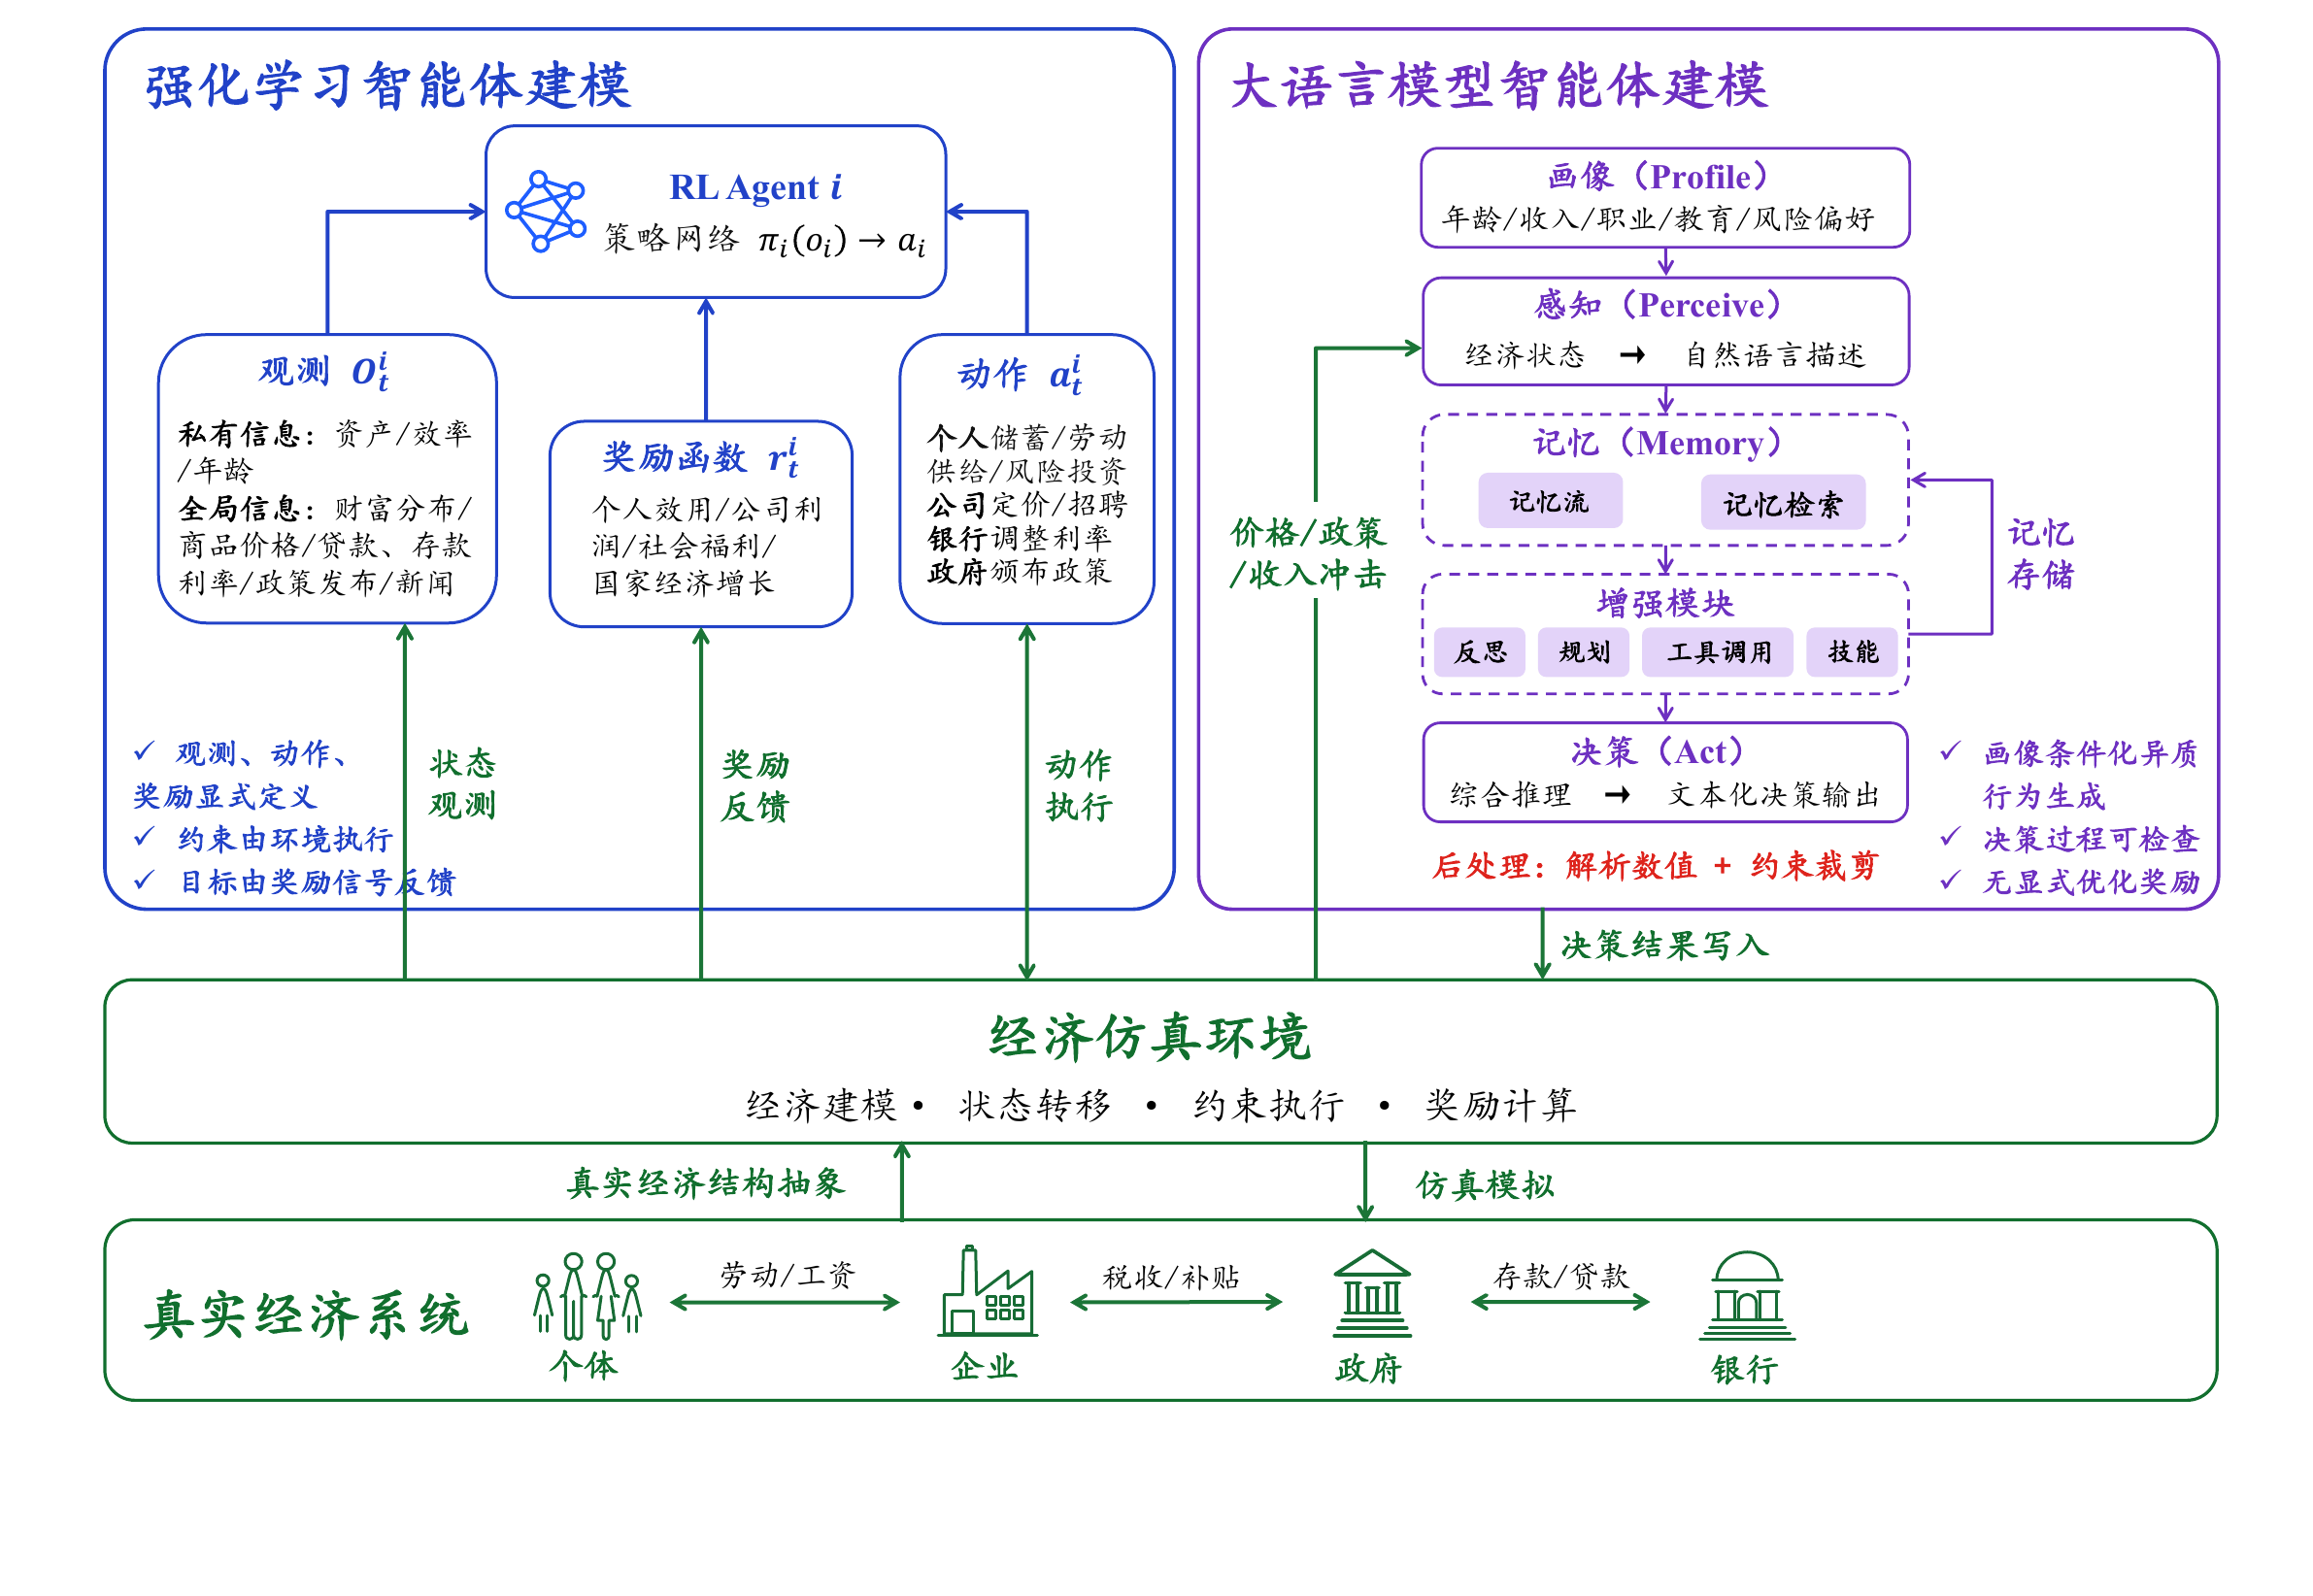
主体表示至少包括观测、行动、目标、约束与信息结构。对于RL主体,奖励函数决定优化方向;对于LLM主体,画像、记忆、感知和行动接口决定情境化行为。
同一经济模型可以有多种主体编码方式。状态是否充分、动作如何离散化、预算约束如何执行,都会改变训练难度和结果的经济含义。
因此,智能体建模应明确回答五个问题:主体看到什么,能做什么,用什么标准评价结果,经济约束由谁执行,以及异质性来自状态、参数、目标还是策略。这些选择不是纯技术细节,而是模型假设的一部分。
RL与LLM是两种不同的主体假设
RL主体通过环境反馈优化研究者给定的奖励,适合序贯决策和策略搜索;LLM主体利用预训练知识、画像与记忆生成行动,适合表达语言化情境和异质性。
RL策略接近最优不代表像真实人类;LLM输出像人也不代表满足经济最优、预算约束或跨期稳定。二者需要不同验证标准,也可以在同一系统中承担不同角色。
RL路径通常显式给出观测空间、动作空间和奖励函数,多主体情形下可表述为部分可观测马尔可夫博弈。例如家庭的观测可同时包括资产、劳动效率等私有状态与工资、价格、利率等公开信号,动作再通过预算约束转化为消费、储蓄、风险投资和劳动供给。
LLM智能体的四个基本模块
LLM经济智能体通常通过四个模块承载决策结构:画像用年龄、收入、职业和风险偏好等条件刻画主体;记忆保存历史经历和决策结果;感知把价格、政策或新闻转化为可用信息;行动模块则把语言推理转成交易、消费或投票等可执行决策。
这些模块并不自动构成经济主体。研究者仍需设定可用信息、记忆窗口、决策格式和制度边界,并检查长期状态追踪、跨期约束遵守、非理性偏差复现以及模型更新后的稳定性。
Step 3:按互动结构选择求解方法
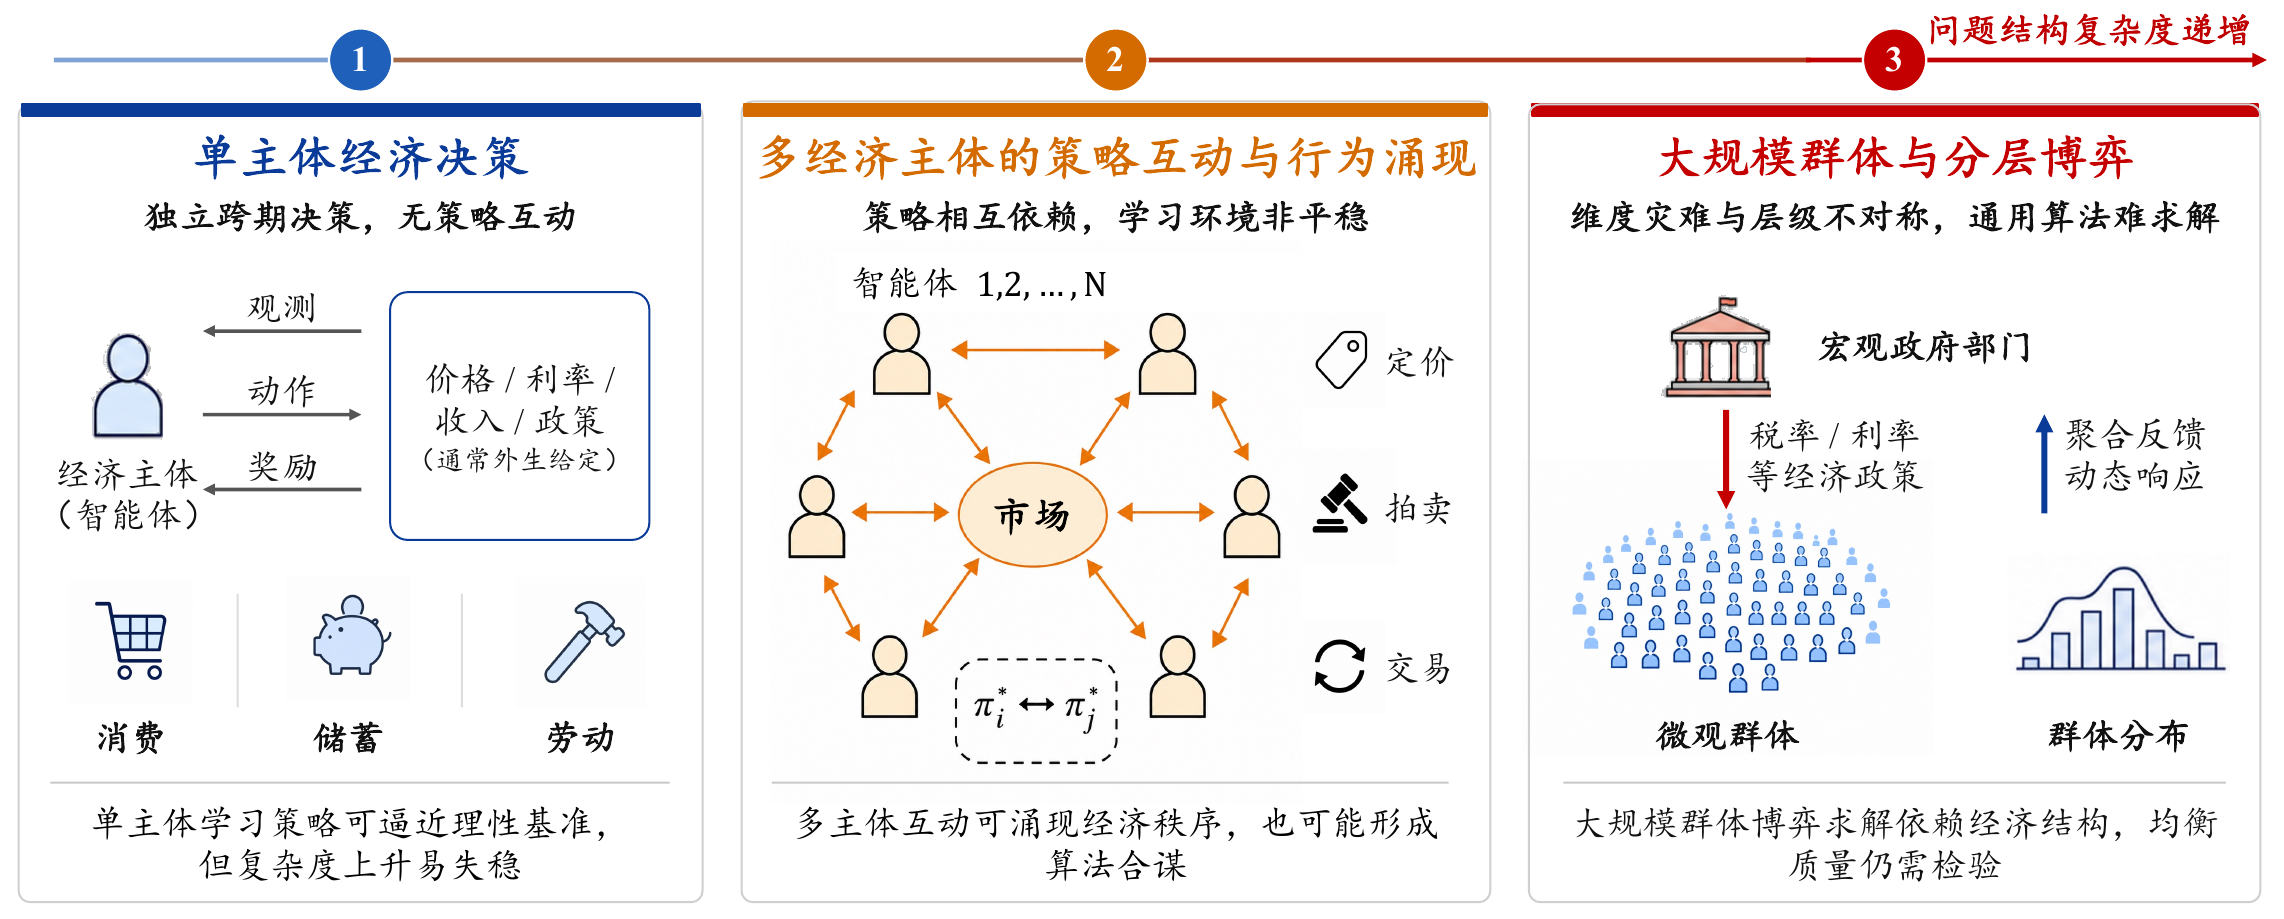
单主体问题可与解析解或高精度数值解比较;多主体共同学习会使每个主体面对的环境不断变化,产生非平稳性;税收、货币与养老金等政策问题还包含制定者与响应者的层级关系。
均值场、参数共享和集中训练分散执行能够扩大规模,Stackelberg结构能够表达政策领导者与微观响应者,但这些近似会改变独立性、异质性或策略空间。
在少数主体市场中,求解结果本身还可成为经济学研究对象。重复定价、拍卖和交易实验表明,RL或LLM智能体可能形成高于竞争基准的价格、事实上的市场分割或对声誉机制的策略性利用。这说明交互结构、通信条件和制度设计都会改变学习行为。
仿真容量、训练规模和策略多样性要分开报告
环境能够运行十万主体,并不表示学习算法能为十万主体稳定训练彼此独立的策略。大规模研究应分别说明环境仿真容量、实际参与训练的主体数量、共享参数方式和有效策略多样性。
训练奖励收敛也不自动等于纳什均衡、竞争均衡或社会福利改善;必须检查与研究结论相对应的经济条件。
对层级政策问题,还要检查领导者策略与下层响应的一致性;对市场博弈,可通过单边偏离收益或经验博弈方法评估均衡质量;对转移过程与周期波动,则应比较轨迹分布、动态矩和冲击恢复时间。
EconGym如何串起四个环节
EconGym以个体、企业、政府和银行四类基础主体为建模单元,向下展开为11种异质角色。每个角色都有自己的方程、观测、动作、目标和交互接口,又通过价格、工资、利率、税收和转移支付等共享变量相互影响。这使同一角色可在不同任务中复用,不同政策角色也能进入同一个跨领域环境。
平台支持规则策略、RL与LLM等多类方法,因而可在共享经济设定下比较算法。但统一接口只提供受控比较的基础,不能隐去每个任务的经济含义、校准责任和特定证据边界。
Step 4:建立多层验证
微观层比较选择、弹性、跨期响应与群体分布;宏观层比较时间序列、横截面分布与典型事实;政策层比较主体对规则变化的内生响应;样本外层覆盖新时期、新制度和压力情景。
单一总体指标拟合良好不能识别唯一机制。可信度来自多层证据、替代模型比较、消融实验、敏感性分析与不确定性报告。
五类挑战可作为结果审核清单:微观行为是否覆盖群体差异和动态响应;宏观涌现是否在未校准事实上仍成立;求解结果是否满足目标均衡或动态性质;政策反事实是否有现实识别证据约束;以及数据、代码、配置和评测是否足以复现。
一项可复现研究至少应报告什么
研究者应把经济结构和算法实现分开说明,并保留足以重建结果的模型、数据与训练信息。平台化研究尤其需要统一接口和配置,但不能用统一API掩盖任务之间的经济差异。
- 经济模型、制度规则、校准目标与数据时间范围
- 主体观测、行动、奖励或提示、记忆与约束执行方式
- 算法、随机种子、训练规模、收敛标准和计算预算
- 基线、经济约束残差、多层验证、失败情景与不确定性
核心阅读
按“奠基方法、代表性应用、验证框架或前沿基础设施”筛选;每篇论文都与本研究板块的核心问题直接对应。
The AI Economist: Taxation policy design via two-level deep multiagent reinforcement learning
Science Advances
论文提出两层深度多智能体强化学习框架:经济主体与社会规划者共同适应,前者学习劳动和交易行为,后者学习税收政策,并用课程学习稳定这一双层优化。在一步经济中,模型能够恢复理论最优税制;在时空经济中,相较基准方法提高了功利主义福利以及公平—生产率权衡。结果同时出现劳动专业化、行为变化和避税策略,说明政策优化必须内生考虑主体对制度的策略性响应。
Artificial Intelligence, Algorithmic Pricing, and Collusion
American Economic Review
论文研究独立运行的Q-learning定价算法在重复寡头竞争中会形成怎样的市场结果。实验发现,即使算法之间没有直接沟通,它们仍会稳定学习到高于竞争水平的价格;这一结果由有限期惩罚和随后逐步恢复合作的策略维持。结论对成本或需求不对称、参与者数量变化及多种不确定性设定均较稳健,表明算法自主学习本身可能产生具有合谋效果的动态互动。
论文针对政府与大量自利家庭之间的动态税收博弈,构建基于Bewley–Aiyagari框架的多智能体强化学习环境TaxAI。模拟器同时包含家庭、政府、企业和金融中介,并用真实数据校准;作者在统一环境中比较两种传统经济方法和七种MARL方法。实验报告MARL在基准任务上整体优于传统方法,系统可扩展至一万户家庭,为税收政策学习提供了更大规模、可复现的算法比较平台。
论文针对传统ABM难以灵活刻画主体异质性和多期宏观信息的问题,提出由大语言模型驱动的EconAgent。感知模块为主体配置不同特征与决策机制,记忆模块让其结合个人历史和市场趋势反思,再在劳动与消费环境中形成选择。模拟结果显示,相较规则型和神经网络型基准,EconAgent产生的个体决策更接近现实,并形成更合理的宏观现象,为自然语言智能体进入自下而上宏观仿真提供了初步证据。
论文提出模块化经济AI测试平台EconGym,用统一接口连接经济任务、主体角色和求解算法。平台实现家庭、企业、银行、政府等11类异质角色及其交互,可组合出25项以上跨领域任务,并支持传统经济方法、AI方法及其混合方案。实验覆盖财政、养老金和货币政策协同,显示更丰富的任务与算法会扩展政策空间,经典经济方法引导的AI主体在复杂场景中表现最佳;系统还可扩展到一万名主体。
Empirical Validation of Agent-Based Models: Alternatives and Prospects
Journal of Artificial Societies and Social Simulation
论文聚焦基于智能体经济模型如何接受经验验证这一方法论难题。作者首先提出一套分类框架,刻画不同ABM在验证目标、数据和模型选择等维度上的差异;随后比较间接校准、Werker–Brenner方法和历史友好方法三条验证路径。文章没有宣称存在统一最佳方案,而是梳理各路径的适用方式与尚未解决的问题,把验证从单一宏观拟合提升为贯穿模型构建的系统任务。