- 用四类研究能力而不是算法名称组织AI经济学文献
- 为行为、测量、因果和预测结果匹配不同证据标准
- 判断多种AI方法如何进入同一项经济研究
一张表看清四类研究能力
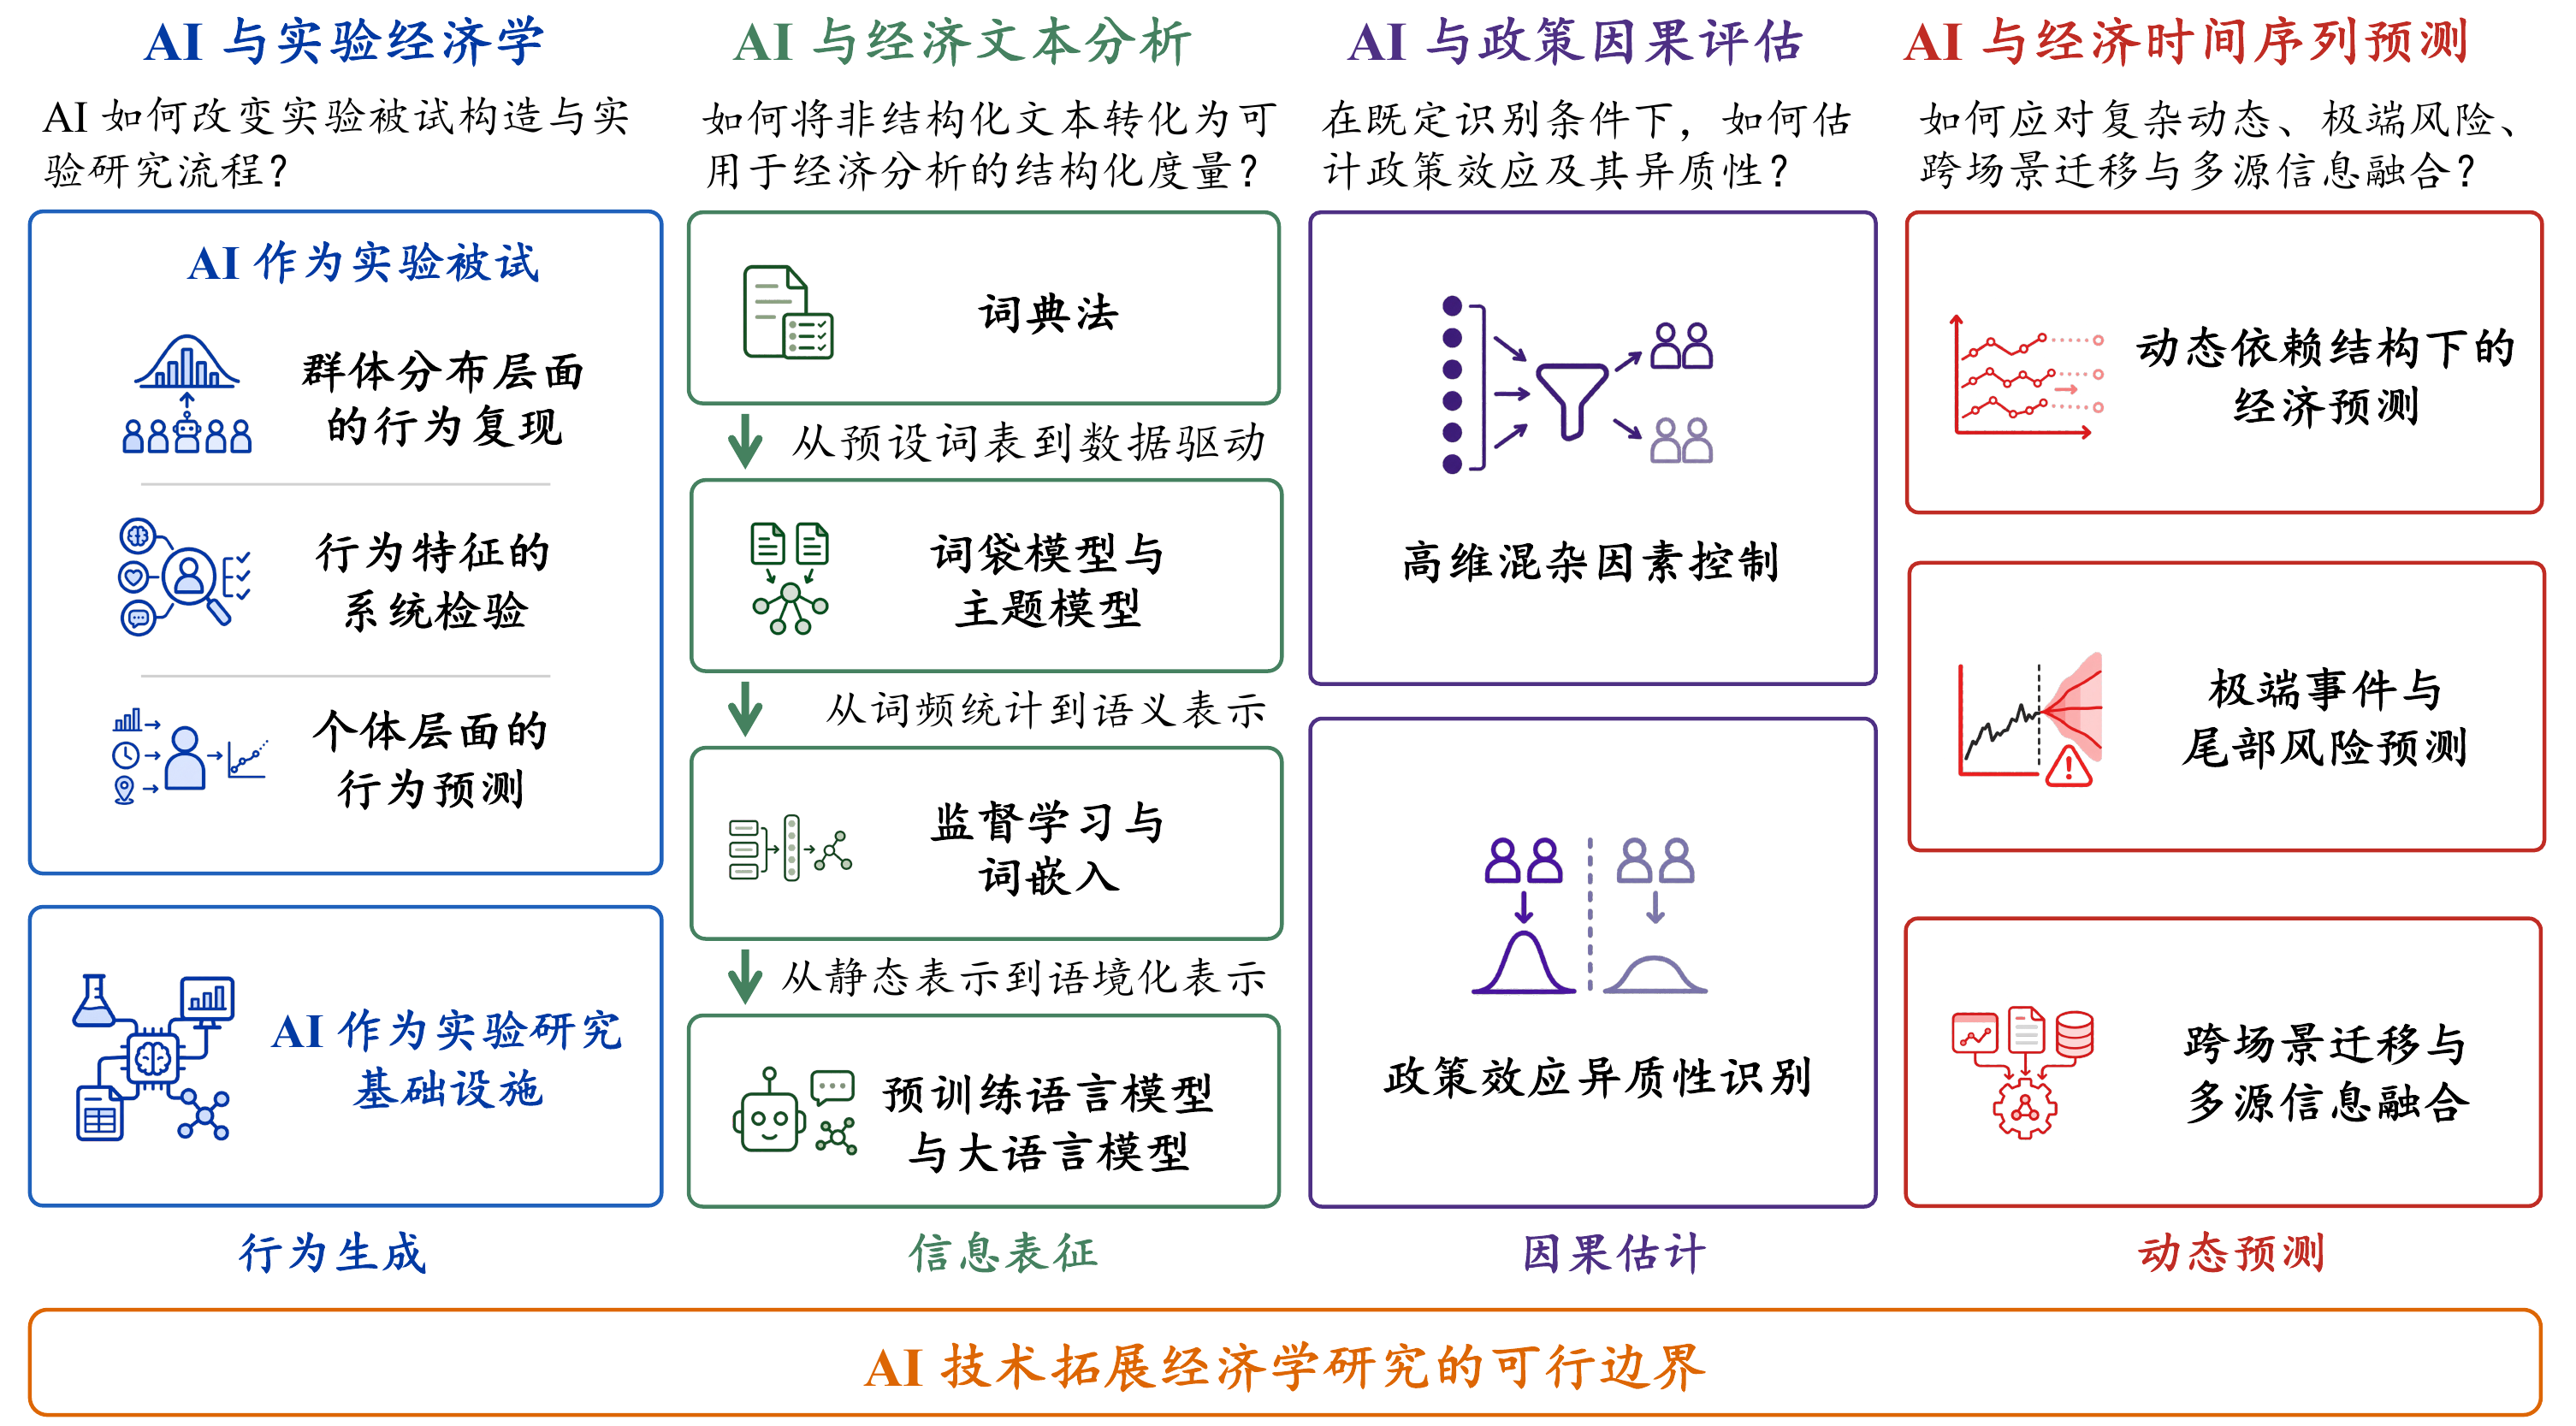
AI进入经济学研究时,最有用的分类不是监督学习、深度学习或大语言模型,而是它在研究链条中承担的任务:生成主体行为、把非结构化信息转化为变量、辅助估计因果参数,以及预测复杂动态。
同一种模型可以承担多种任务,但任务不同,验证对象也不同。行为相似、测量有效、因果可信和预测准确不能互相替代。
这四类能力分别以实验经济学、经济文本分析、政策因果评估和经济时间序列预测为代表场景。这不是对AI经济应用的穷尽罗列,而是用研究输出和证据标准建立一套可比较的方法坐标。
- 行为生成:输出选择、回答或策略;比较均值、分布、个体与跨任务稳定性
- 信息表征:输出标签、主题或向量;检验语境、标注一致性与外部效度
- 因果估计:输出处理效应;依赖识别假设、正交化、交叉拟合与稳健性检验
- 动态预测:输出路径或概率分布;依赖滚动样本外、结构突变与实时数据评价
行为生成:LLM是合成被试,不是真实被试
LLM可以根据实验指令和主体画像生成选择,为探索假设、检查材料和开展敏感性分析提供低成本基础设施。但模型没有真实收入、风险与机会成本,其输出首先是模型行为。
证据应从处理效应方向和群体均值,逐步推进到完整分布、个体预测、跨任务一致性及对提示和模型版本的稳定性。只有在明确验证层级后,才能判断合成被试适合探索、预注册辅助还是正式证据。
经典实验经济学依赖“诱发价值”:被试的金钱报酬与选择直接挂钩,研究者才能从真实利益下的决策推断偏好。LLM不满足这一前提,因此它的经济行为有效性必须另行验证。
从群体复现到个体预测
现有研究大致经历三个递进层次。第一层比较LLM与人类在经典博弈中的处理效应方向、平均选择和完整分布;第二层系统检验社会偏好、静态理性、动态信念更新与多步策略推理;第三层才是利用人口属性、世界观或深度访谈信息预测某一具体个体。
当前证据提示出稳定的能力边界:LLM可能复现部分群体效应,但常表现得更亲社会、答案过度集中,且偏好异质性弱于真实人群。它在静态单步任务中可能表现出较高的选择一致性,却不一定能在重复博弈中稳定识别对手规律或形成跨期协调。
- 群体复现:处理效应方向、均值和完整分布是不同标准
- 系统检验:同时关注偏差、异质性、提示敏感性与模型间稳定性
- 个体预测:区分态度问卷的复现与真实经济行为的预测
AI也可以成为实验研究基础设施
AI的另一个角色是嵌入实验设计、实施与分析流程:协助编写和检查指令、统一规则解释、监测被试依从性、编码开放文本,或根据被试背景调整问卷表达。评价重点此时不再是“像不像人”,而是流程一致性、错误率、可审计性和研究者责任。
使用独立API会话、随机排列选项或非零温度采样,可以降低不同调用间的表面重复,却不足以保证合成样本满足传统统计推断的独立同分布假设。模型记录、版本锁定、透明性和可复现性因而应成为研究设计的一部分。
信息表征:从词典法到大语言模型
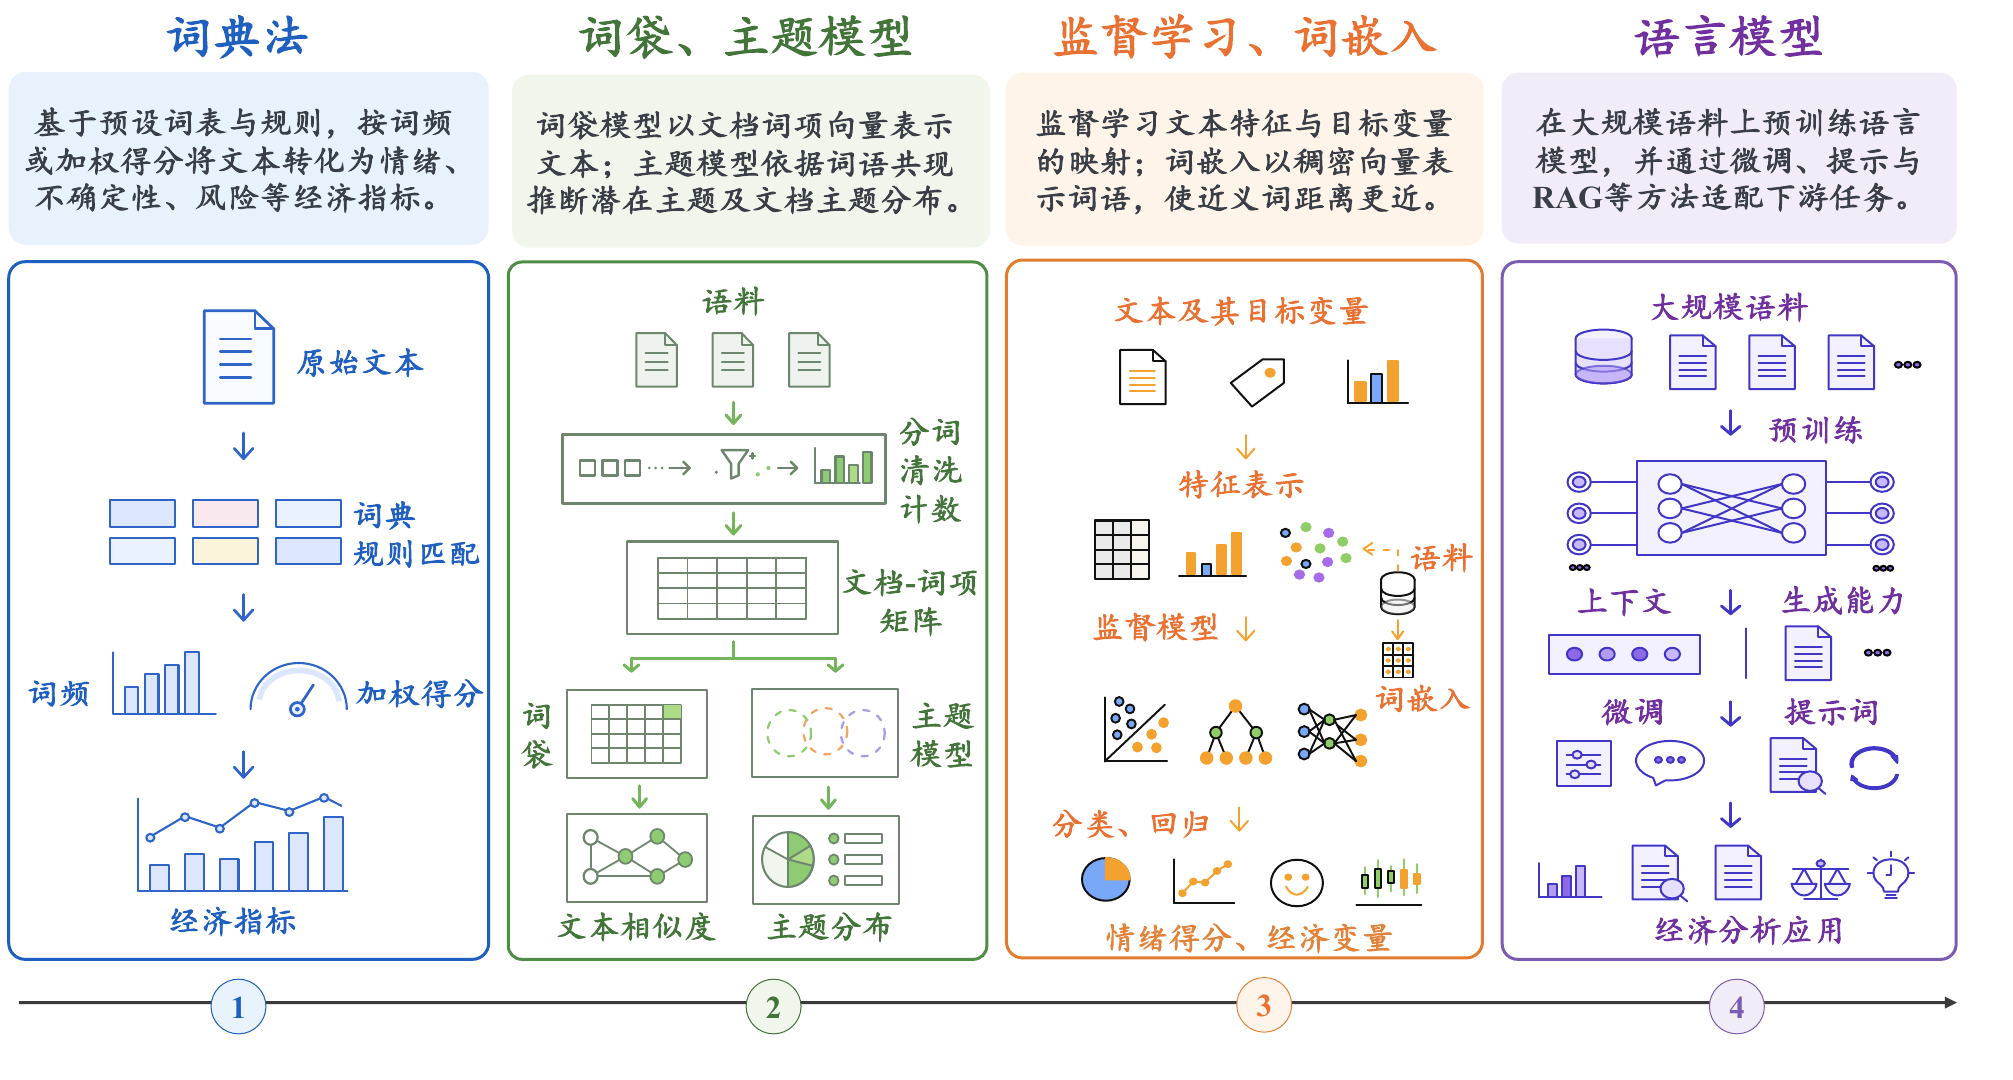
词典法和主题模型透明、成本低,但难以处理否定、多义和领域语境;监督学习与词嵌入提高了语义表达能力,却依赖标注与训练样本;预训练模型和LLM支持语境化抽取,但也引入提示敏感性与版本变化。
文本模型构造的是经济测量变量。研究者必须说明标签的经济含义,并使用领域标注、人工复核和外部结果变量验证它。
方法演进的关键不只是模型更大,而是表征单元从词频、主题和静态词向量,扩展到可利用句子与文档上下文的语境化表示。这使政策立场、金融情绪、叙事与风险暴露等难直接观测的概念更易进入实证研究,同时也把构念效度和跨时期可比性推到了更核心的位置。
因果估计:机器学习改善估计,不创造识别
双重机器学习利用灵活模型估计高维干扰函数,再通过正交得分与交叉拟合降低正则化和过拟合对目标参数的影响;因果森林等方法则帮助刻画条件平均处理效应。
这些方法解决的是给定识别条件下的估计问题。未观测混杂、反向因果或政策改变行为规则时,更强的预测器仍不能自动给出可信因果效应。
在高维控制方面,方法从双重选择Lasso扩展到DML与更一般的局部稳健估计;在政策效应异质性方面,因果树、因果森林、广义随机森林和元学习器将分析从平均效应推向高维特征空间中的条件效应。算法发现的子群差异仍需要制度背景、预先设定的验证样本和可实施的政策约束来解释。
动态预测:必须面对时间顺序与结构变化
深度时序模型和基础模型能够处理非线性、长依赖和跨数据集迁移,但随机划分训练集与测试集会破坏经济时间顺序。规范评价应使用滚动或扩展窗口的样本外检验。
平均误差还不足以评价宏观和金融风险。概率校准、分位数表现、极端情景、数据修订和制度变化后的稳定性同样重要。
技术路线从ARIMA、VAR和GARCH等结构化基准,扩展到RNN、LSTM与Transformer的长依赖建模,再发展到图结构的多变量联动、DeepAR等概率预测以及TimeGAN等生成式情景构造。这些方法拓展了可表达的动态类型,却不能用总体分布相似代替对危机时期尾部依赖和风险传导路径的检验。
四类能力如何组合成一项研究
一项政策研究可以先用文本模型从新闻或政策文件构造变量,再用因果方法估计处理效应,并把估计结果用于仿真校准;实验数据也可以用于检验AI生成行为。方法可以串联,但每一步都要保留独立的误差来源和验证标准。
组合设计的关键是不让上游误差在下游被遗忘。例如,文本指标的测量误差会进入因果估计,因果参数的不确定性又会进入仿真校准。因此,每个环节都应明确输入、输出、识别假设、评价样本和失效条件。
- 先写清研究问题与目标变量,再选择模型
- 分别报告测量误差、识别假设和预测误差
- 保留模型版本、提示、数据时间戳与复现实验配置
- 把适用边界写进结论,而不是留在附录
核心阅读
按“奠基方法、代表性应用、验证框架或前沿基础设施”筛选;每篇论文都与本研究板块的核心问题直接对应。
Generative AI for Economic Research: Use Cases and Implications for Economists
Journal of Economic Literature
论文系统梳理大语言模型如何辅助经济研究,覆盖构思与反馈、写作、背景研究、数据分析、编程和数学推导六个领域的数十种用例。作者提供操作原则与具体示例,并按“实验性”到“高度实用”评价不同能力,而非把所有任务一概视为成熟。核心判断是,自动化大量研究微任务能够带来显著生产率提升;文章同时讨论认知自动化的长期影响,并通过在线资源持续更新能力边界。
Large Language Models as Simulated Economic Agents: What Can We Learn from Homo Silicus?
ACM Conference on Economics and Computation
论文提出“硅基人”(Homo silicus)概念:把大语言模型视为由训练数据隐式形成的人类计算模型,并像设定经济人一样赋予其禀赋、信息和偏好。作者将六组经典经济实验转化为可控模拟,比较模型行为与原始人类实验结果。多数实验得到定性相近的处理效应,差异则用于暴露模型边界并生成新的研究问题,为将LLM作为经济行为探索工具提供了系统框架。
Text as Data
Journal of Economic Literature
这是一篇面向经济研究者的文本分析方法综述,核心问题是如何把日益增长的数字文本转化为可用于经济分析的变量。论文先说明文本相较结构化数据在高维、语境和表示方式上的特殊性,再概览相关统计方法及其应用。它提供的是研究设计与方法地图,而非单一模型的性能结论,重点在于让文本测量与具体经济问题、验证标准相匹配。
Double/debiased machine learning for treatment and structural parameters
The Econometrics Journal
论文研究在高维干扰参数存在时,如何对低维处理效应或结构参数进行有效推断。作者指出,直接把正则化机器学习结果代入估计方程会因正则化偏差和过拟合而失去根号样本量收敛。双重/去偏机器学习结合Neyman正交得分与交叉拟合,降低目标参数对干扰函数误差的敏感性,并在较弱条件下获得近似无偏、渐近正态的估计;框架覆盖部分线性模型、工具变量、ATE、ATT和LATE等问题。
论文探索时间序列能否像语言一样通过大规模预训练获得跨任务迁移能力。模型采用带输入分块的仅解码器注意力架构,在包含真实与合成序列的大型语料上预训练,再直接对未见数据进行零样本预测。跨领域、预测跨度和时间粒度的实验表明,其开箱即用的零样本精度接近各数据集分别训练的先进监督模型,支持时间序列基础模型的可行性。